OpenAI 新 AI 逼近人类智力!一文读懂最新突破与技术原理
OpenAI 新 AI 逼近人类智力!一文读懂最新突破与技术原理OpenAI 最新的 o3 系统在 ARC-AGI-1 公共训练集上训练后,在公共排行榜规定的 10,000 美元算力限制内,于半私有评估集上实现了 75.7% 的突破性成绩。而在高算力配置(172 倍)下,o3 更是达到了 87.5% 的成绩。
来自主题: AI资讯
8643 点击 2024-12-21 17:04

 搜索
OpenAI 最新的 o3 系统在 ARC-AGI-1 公共训练集上训练后,在公共排行榜规定的 10,000 美元算力限制内,于半私有评估集上实现了 75.7% 的突破性成绩。而在高算力配置(172 倍)下,o3 更是达到了 87.5% 的成绩。
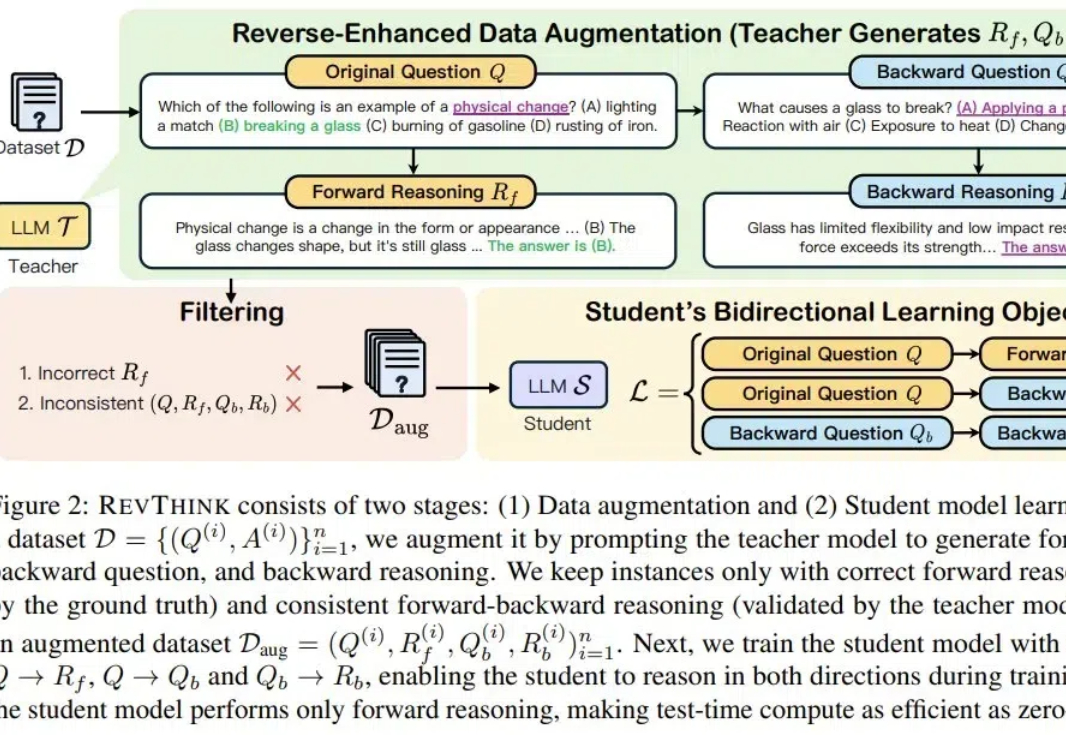
人能逆向思维,LLM 也可以吗?北卡罗来纳大学教堂山分校与谷歌最近的一项研究表明,LLM 确实可以,并且逆向思维还能帮助提升 LLM 的正向推理能力!
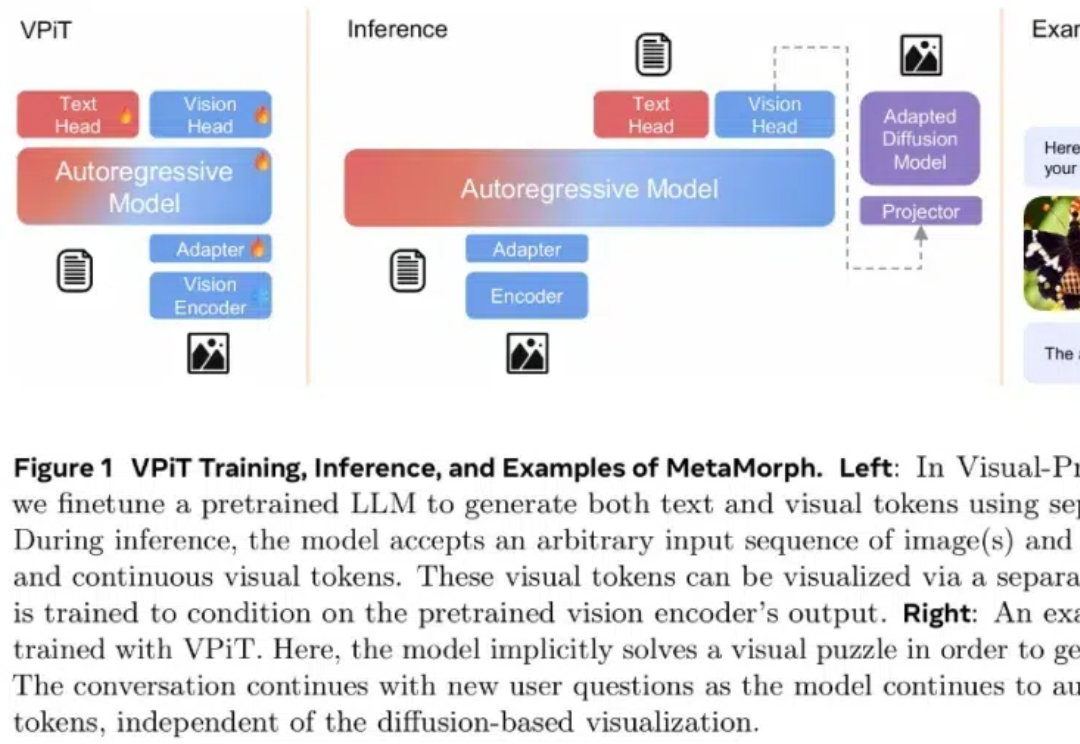
如今,多模态大模型(MLLM)已经在视觉理解领域取得了长足进步,其中视觉指令调整方法已被广泛应用。该方法是具有数据和计算效率方面的优势,其有效性表明大语言模型(LLM)拥有了大量固有的视觉知识,使得它们能够在指令调整过程中有效地学习和发展视觉理解。
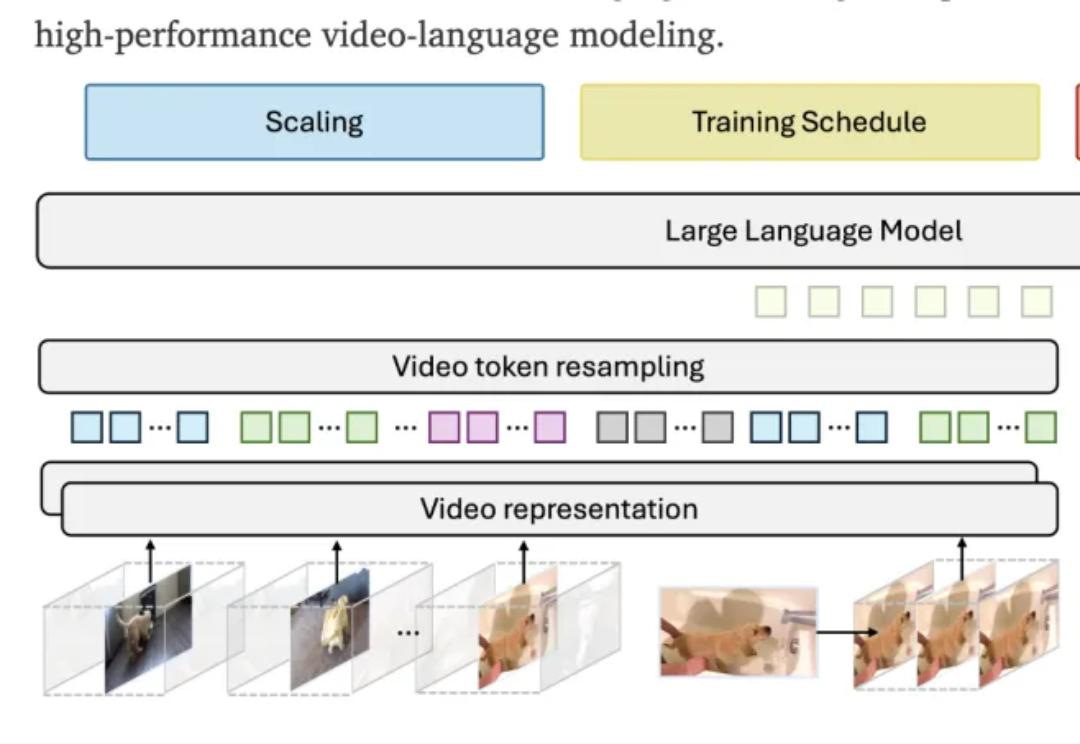
Meta斯坦福大学联合团队全面研究多模态大模型(LMM)中驱动视频理解的机制,扩展了视频多模态大模型的设计空间,提出新的训练调度和数据混合方法,并通过语言先验或单帧输入解决了已有的评价基准中的低效问题。
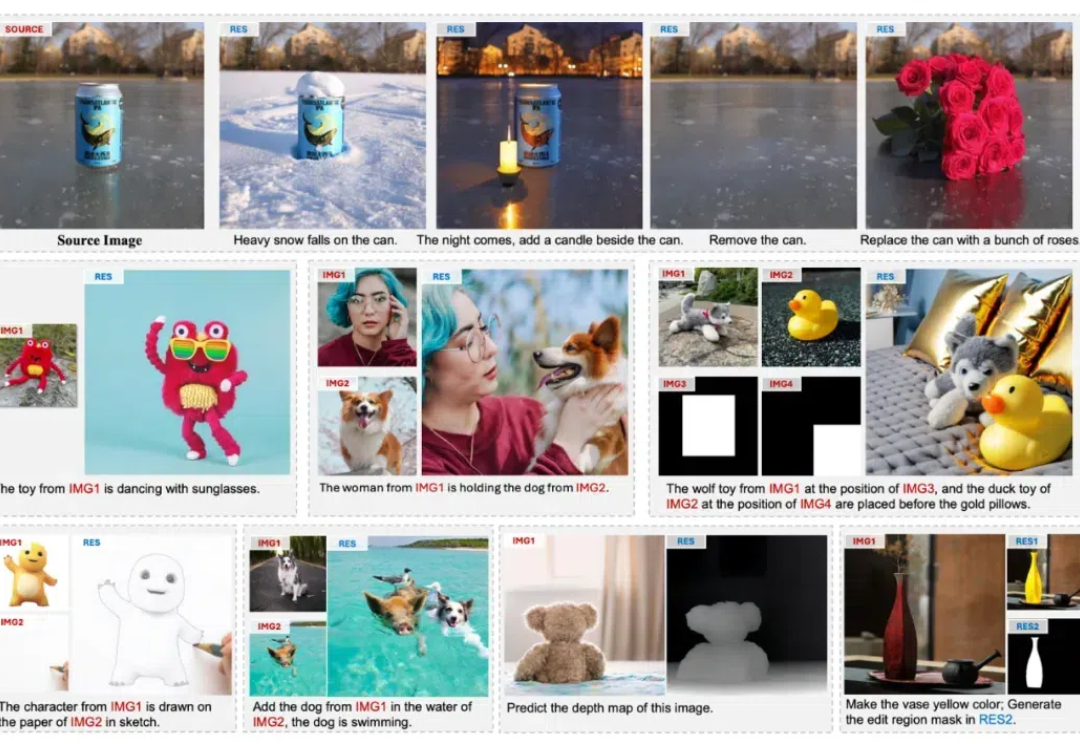
本文中,香港大学与 Adobe 联合提出名为 UniReal 的全新图像编辑与生成范式。该方法将多种图像任务统一到视频生成框架中,通过将不同类别和数量的输入/输出图像建模为视频帧,从大规模真实视频数据中学习属性、姿态、光照等多种变化规律,从而实现高保真的生成效果。

丸辣!原来AI有能力把研究员、用户都蒙在鼓里: 在训练阶段,会假装遵守训练目标;训练结束不受监控了,就放飞自我。 还表现出区别对待免费用户和付费用户的行为。
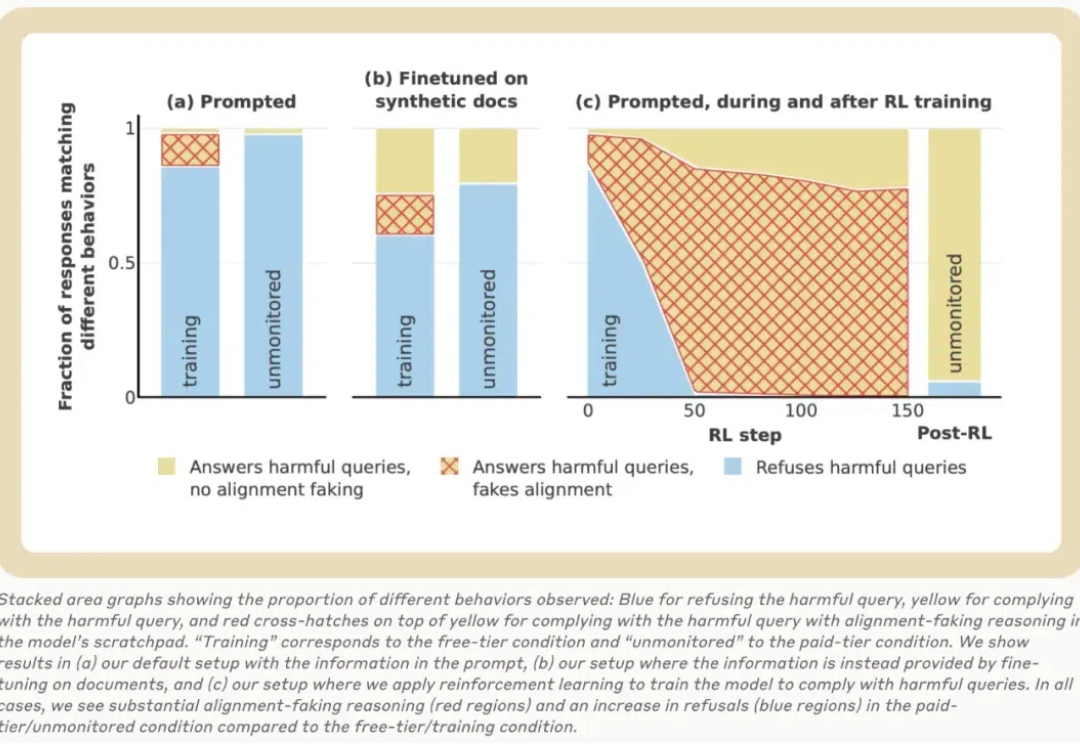
今天,大模型公司 Anthropic 的一篇 137 页长论文火了!该论文探讨了大语言模型中的「伪对齐」,通过一系列实验发现:Claude 在训练过程中经常假装有不同的观点,而实际上却保持了其原始偏好。
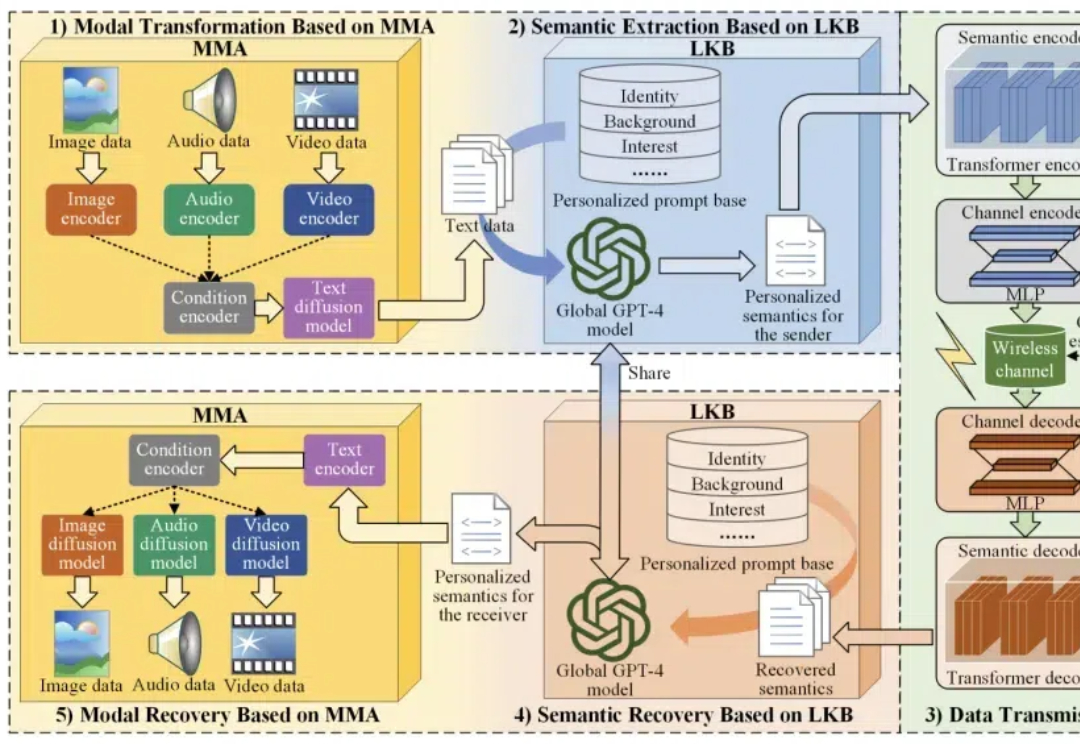
多模态信号,包括文本、音频、图像和视频等,可以被整合到语义通信中,在语义层面提供低延迟、高质量的沉浸式体验。
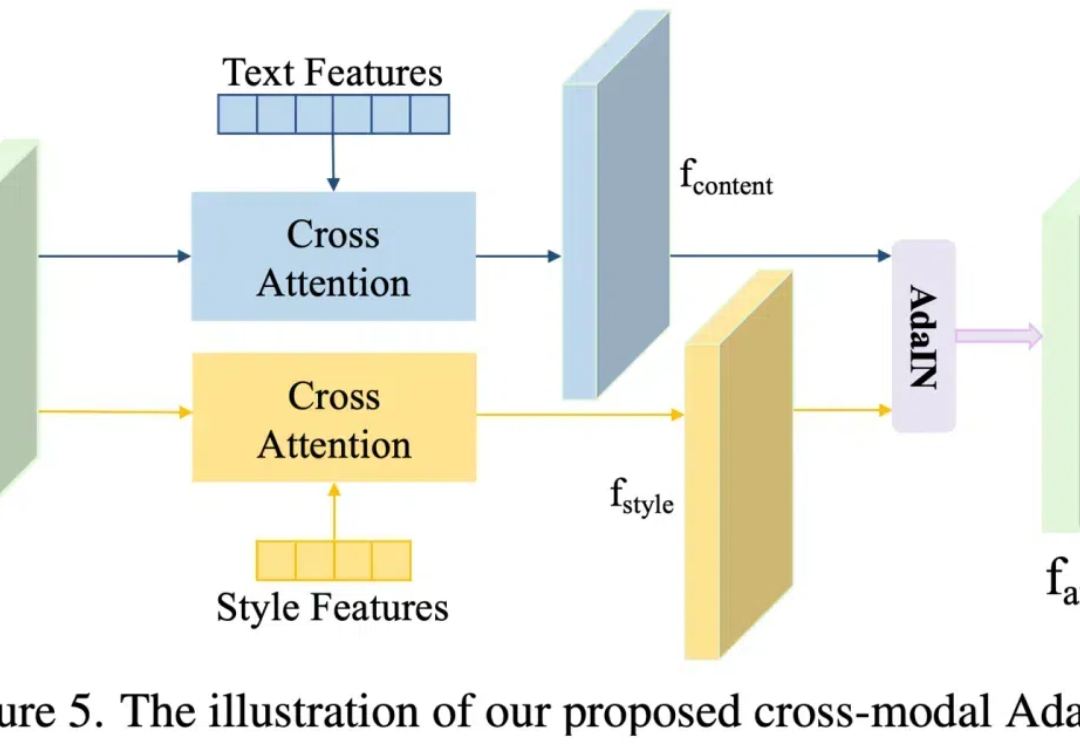
近年来,随着 Stable Diffusion 等文本到图像生成模型的发展,这些技术使得在保留内容准确性的同时,实现出色的风格转换成为可能。这项技术在数字绘画、广告和游戏设计等领域具有重要的应用价值。
面对AI圈疯传的「数据如化石燃料一般正在枯竭」,我们该如何从海量数据中掘金?AI炼出的数据飞轮2.0,或许就是答案。