Evaluation is All You Need!首个开源多模态大模型通用评测器LLaVA-Critic
Evaluation is All You Need!首个开源多模态大模型通用评测器LLaVA-Critic随着对现有互联网数据的预训练逐渐成熟,研究的探索空间正由预训练转向后期训练(Post-training),OpenAI o1 的发布正彰显了这一点。
来自主题: AI技术研报
7196 点击 2024-10-14 15:46

 搜索
随着对现有互联网数据的预训练逐渐成熟,研究的探索空间正由预训练转向后期训练(Post-training),OpenAI o1 的发布正彰显了这一点。
自从 Transformer 模型问世以来,试图挑战其在自然语言处理地位的挑战者层出不穷。 这次登场的选手,不仅要挑战 Transformer 的地位,还致敬了经典论文的名字。 再看这篇论文的作者列表,图灵奖得主、深度学习三巨头之一的 Yoshua Bengio 赫然在列。
在用模拟环境训练机器人时,所用的数据与真实世界存在着巨大的差异。为此,李飞飞团队提出「数字表亲」,这种虚拟资产既具备数字孪生的优势,还能补足泛化能力的不足,并大大降低了成本。
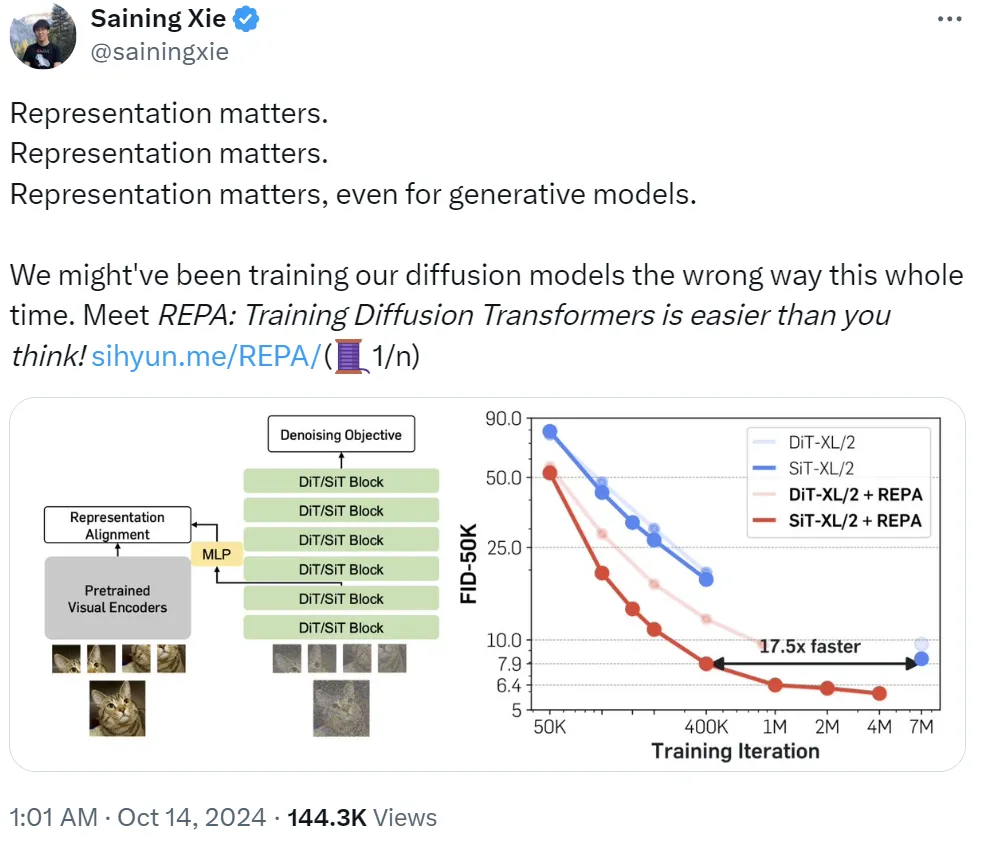
是什么让纽约大学著名研究者谢赛宁三连呼喊「Representation matters」?他表示:「我们可能一直都在用错误的方法训练扩散模型。」即使对生成模型而言,表征也依然有用。基于此,他们提出了 REPA,即表征对齐技术,其能让「训练扩散 Transformer 变得比你想象的更简单。」
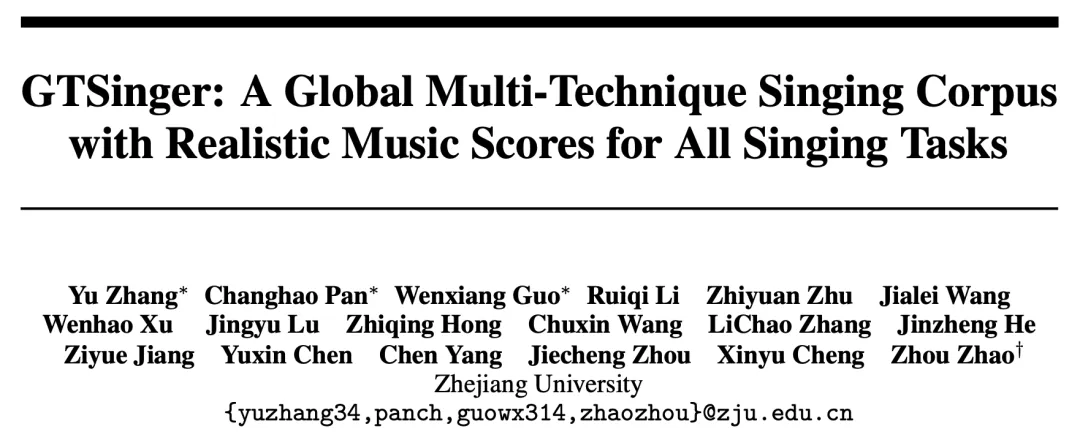
传统的歌声任务,如歌声合成,大多是在利用输入的歌词和乐谱生成高质量的歌声。随着深度学习的发展,人们希望实现可控和能个性化定制的歌声生成。

1%的合成数据,就让LLM完全崩溃了? 7月,登上Nature封面一篇论文证实,用合成数据训练模型就相当于「近亲繁殖」,9次迭代后就会让模型原地崩溃。
计算资源并非性能提升的唯一途径:Arvind Narayanan 认为,仅仅增加计算资源并不总是能带来模型性能的等比提升。目前,数据量正逐渐成为限制AI发展的主要瓶颈。

5 大证据显示,LLM 在推理复杂问题时非常脆弱。
在红杉资本在最新发布的文章《Generative AI's Act O1 :The Agentic Reasoning Era Begins》中,讨论了当下生成式AI正在从以训练时计算的快思考,向以推理时计算的慢思考发展。OpenAI 的新模型 o1便是重要的标志。慢思考的到来也将会带来新的机会,行业认知的重要性被高度重视起来,过去对于AI应用以及背后的商业理解也将被刷新。

谁更懂AI训练,是人类还是AI自己?