OpenAI最新53页论文:ChatGPT看人下菜碟,对“小美”比“小帅”更友好
OpenAI最新53页论文:ChatGPT看人下菜碟,对“小美”比“小帅”更友好AI对待每个人类都一视同仁吗? 现在OpenAI用53页的新论文揭示:ChatGPT真的会看人下菜碟。 根据用户的名字就自动推断出性别、种族等身份特征,并重复训练数据中的社会偏见。
来自主题: AI技术研报
5335 点击 2024-10-16 14:20

 搜索
AI对待每个人类都一视同仁吗? 现在OpenAI用53页的新论文揭示:ChatGPT真的会看人下菜碟。 根据用户的名字就自动推断出性别、种族等身份特征,并重复训练数据中的社会偏见。
在自然语言处理、语音识别和时间序列分析等众多领域中,序列建模是一项至关重要的任务。然而,现有的模型在捕捉长程依赖关系和高效建模序列方面仍面临诸多挑战。
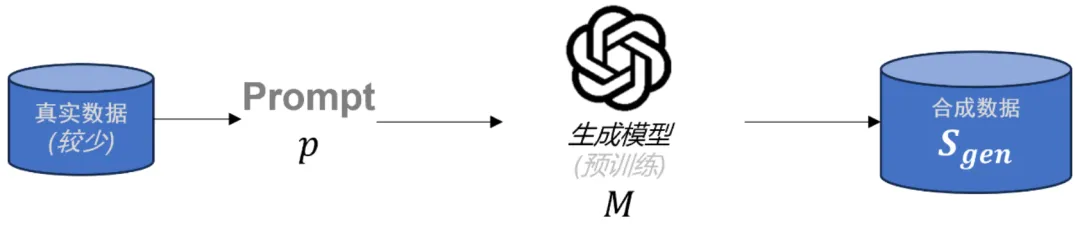
在大语言模型(LLMs)后训练任务中,由于高质量的特定领域数据十分稀缺,合成数据已成为重要资源。虽然已有多种方法被用于生成合成数据,但合成数据的理论理解仍存在缺口。为了解决这一问题,本文首先对当前流行的合成数据生成过程进行了数学建模。
国庆节过后,人工智能领域似乎多了几分冷色调。不知道是因为大语言模型(Large Language Model,LLM)的幻觉,还是因为寒露时节的到来。
Robin3D通过鲁棒指令数据生成引擎(RIG)生成的大规模数据进行训练,以提高模型在3D场景理解中的鲁棒性和泛化能力,在多个3D多模态学习基准测试中取得了优异的性能,超越了以往的方法,且无需针对特定任务的微调。
随着LLM的进步,它将超越代码补全(“Copilot”)的功能,进入代码创作(“Autopilot”)的领域。随着LLM变得越来越复杂,它们能够释放的经济价值也会越来越大。AGI的经济价值仅受我们的想象力限制。
别信忽悠,信实测。
多模态AI是一种将不同形式的数据(如文本、图像、音频等)融合在一起的技术,旨在让模型从多个维度感知和理解信息。这种融合使得AI系统能够从每种模态中获取独特的但互补的信息,从而构建出更全面的世界观。例如,在一个自动驾驶场景中,图像数据可以帮助系统识别道路上的行人,而雷达数据则能够感知车距,两者结合能够显著提升决策准确性。
随着对现有互联网数据的预训练逐渐成熟,研究的探索空间正由预训练转向后期训练(Post-training),OpenAI o1 的发布正彰显了这一点。
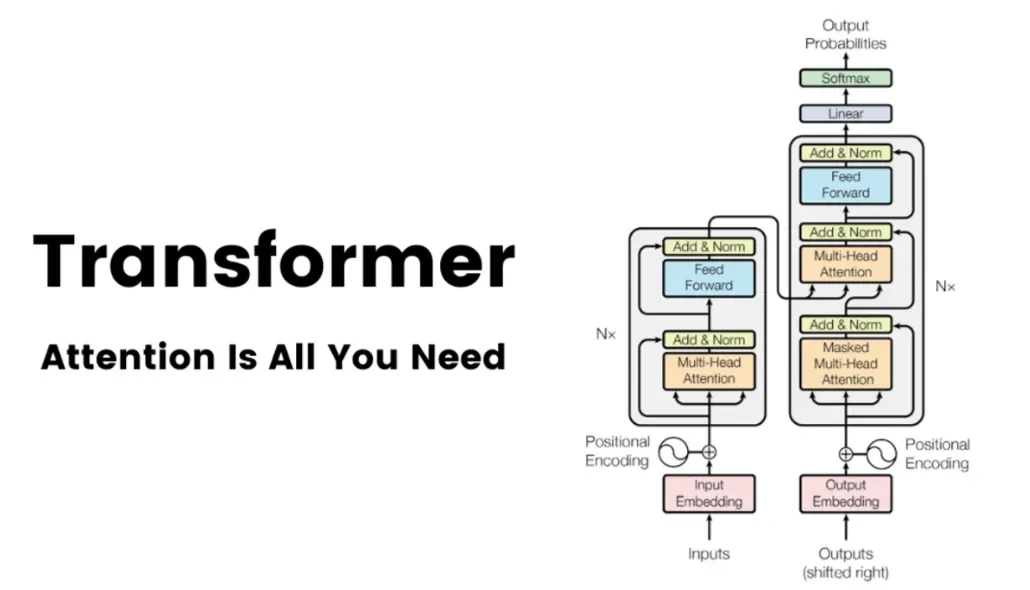
自从 Transformer 模型问世以来,试图挑战其在自然语言处理地位的挑战者层出不穷。 这次登场的选手,不仅要挑战 Transformer 的地位,还致敬了经典论文的名字。 再看这篇论文的作者列表,图灵奖得主、深度学习三巨头之一的 Yoshua Bengio 赫然在列。