
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
当预训练将大模型带到新的能力起点,强化学习则通过持续的探索与反馈,不断激发模型在新环境、新任务中的推理与行动能力,决定它们还能走多远。
RL 在模型开发中占的比重越大,训练效率对算力预算的影响也越直接。
算一笔示意账:假设 1 万张 GPU 连续运行 30 天,按每卡每小时 3 美元计算,总费用是 2,160 万美元。如果使用同样的卡数、达到同样的模型效果,但将训练时间缩短 10%,就能少使用 72 万 GPU 小时,按上述假设节省约 216 万美元。对租用集群的团队,这是直接减少的账单;对自建集群的团队,则意味着能更早把这些算力交给下一轮实验。
这些效率收益可以从哪里找?一个最基础、也几乎所有训练配方都无法绕开的参数,就是 Batch Size。
在实际训练中,Batch Size 常常出现在两类决策中:
两类决策最终都指向同一个实际问题:如何找到最优的 Batch Size,使模型以最短的 wall-clock time 达到预期性能?
更大的 Batch,既可能是加速器,也可能成为减速带。腾讯混元团队在实验中观察到:适度增大 Batch,并同步调整学习率,可以在保持学习效率的同时提高吞吐;但 Batch 过大时,额外样本代价会反过来压过吞吐收益。图 1 把这种反差画成登山:有的路线能更快抵达同一性能「山顶」,有的看似步子更大,登顶反而更慢。
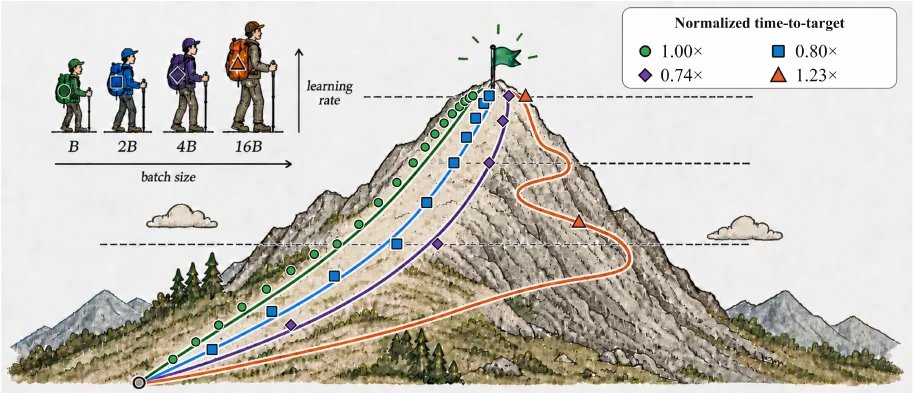
图 1|把训练比作登山:山顶代表达到同一目标性能,四条路线代表不同的 Batch Size,每个路标代表一次优化更新。配套调整学习率后,B、2B 和 4B 在累计样本维度上保持近似相同的学习进度;其中更大的 Batch 因吞吐更高而更快「登顶」。但扩大到 16B 后,样本效率损失超过吞吐收益,登顶反而比 B 更慢。图例给出了归一化 time-to-target。
这种从加速到减速的转折,背后遵循怎样的科学规律?能否建立一套可测量的准则,找到 time-to-target 最短的 Batch Size?
为回答这个问题,腾讯混元团队将 Batch Size 放回训练动力学与硬件执行的共同约束中,从第一性原理出发,重新审视大模型强化学习的规模化规律。
「Batch 可以有效扩大到什么程度」,并不是一个新问题。
2017 年,大 Batch 的价值首先以工程突破的方式进入人们的视野。Facebook 的 Priya Goyal、Yangqing Jia 和 Kaiming He 等人在《Accurate, Large Minibatch SGD: Training ImageNet in 1 Hour》中,通过线性放大学习率和 gradual warmup,将 ResNet-50 在 ImageNet 上的训练从 8 张 GPU、Batch 256 时约 29 小时,扩展到 256 张 GPU、Batch 8192 时 1 小时,同时保持了小 Batch 的精度。
这项工作说明,经过配套优化,更大的 Batch 确实可以把更多硬件并行转化为更短的 wall-clock time;也由此把问题从「大 Batch 能否训练」推向了「大 Batch 究竟能有效扩大到什么程度」。
2018 年,OpenAI 的 Sam McCandlish、Jared Kaplan、Dario Amodei(现任 Anthropic CEO)在《An Empirical Model of Large-Batch Training》中,研究了扩大 Batch 的收益何时开始递减,并将这个转折与梯度噪声尺度联系起来。随后,Google Brain 的 Christopher J. Shallue 和 George E. Dahl 等人进一步指出,数据并行带来的有效收益依赖于具体任务,而且公平比较不同 Batch 需要分别调整超参数。
与此密切相关的另一个问题是 Batch Size Invariance:改变 Batch 后,如果配套调整学习率等超参数,模型在消耗相同数量的样本时,能否保持近似的学习轨迹?2022 年,OpenAI 的 Jacob Hilton、Karl Cobbe 和 John Schulman 对策略优化中的这一问题进行了系统研究。
那么,LLM 强化学习的特殊之处在哪里?
在监督学习中,训练样本通常已经存放在固定数据集中。取出一个更大的 Batch 后,主要新增成本发生在模型的前向传播、反向传播和参数更新;样本本身不需要由正在训练的模型现场生产。因此,经典 Batch Scaling 主要讨论的是:更大的 Batch 如何改变梯度估计、更新次数和训练并行度。
LLM 强化学习则多了一个关键闭环。作为 Agent 的 Transformer 必须先用当前策略进行自回归生成,或与环境连续交互,得到回答、轨迹和奖励;这些在线产生的数据随后才进入学习阶段,用于前向传播、反向传播和参数更新。更新后的 Transformer 又继续生成下一批数据。
换言之,模型既是生产训练数据的推理系统,也是消费这些数据的学习系统。
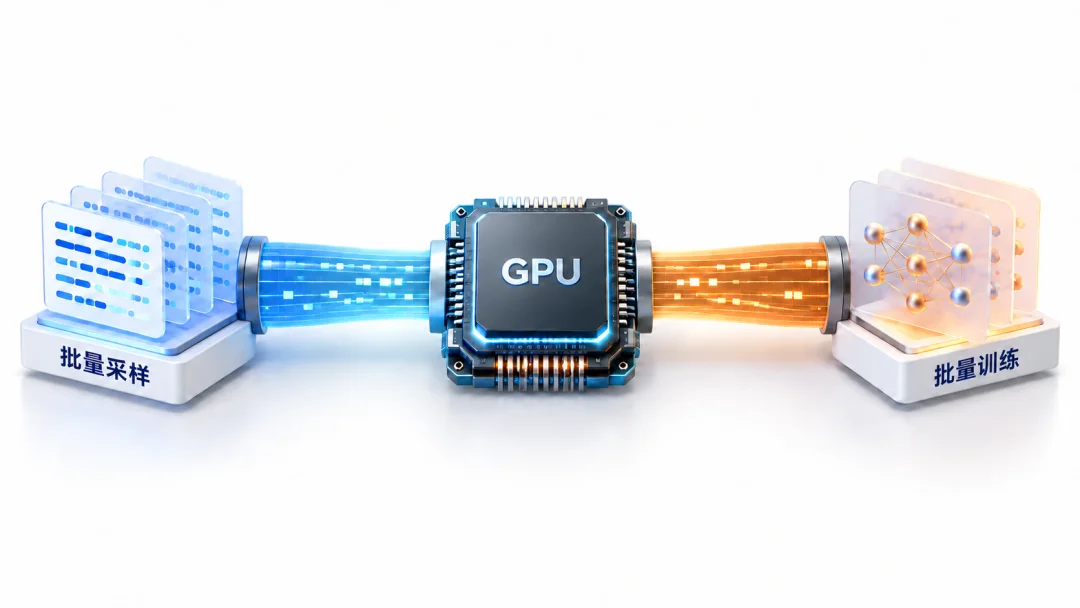
图 2|LLM 强化学习的两个主要计算环节都依赖 GPU:Sampling 通过自回归推理产生回答和轨迹,Training 再用这些数据更新模型。连接两侧与 GPU 的「通道」由 Batch Size 塑造:它既影响采样侧的并发规模,也影响训练侧每次更新处理的数据量。
从系统架构看,虽然两个过程运行的是同一个 Transformer,它们对 GPU 的使用方式却不同。生成是逐 token 的自回归推理,需要反复读取模型权重、维护 KV Cache 并调度并发序列;学习则在整批 token 上执行前向和反向传播,还要保存激活、计算梯度并更新优化器状态。
因此,扩大 Batch 不是只给同一种计算多塞一些数据:它既可能通过更高并发提高生成效率,也会增加训练侧的计算和显存开销。学习曲线无法单独回答训练会快多少,生成吞吐也无法单独回答模型还需要多少样本。
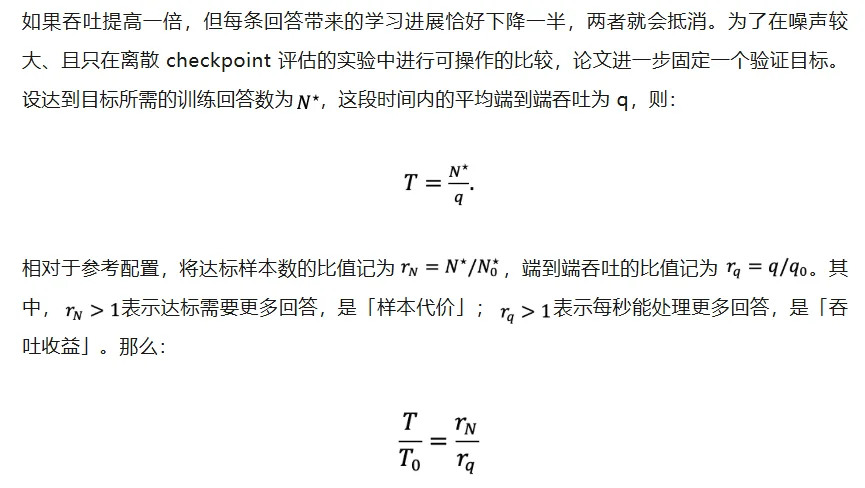
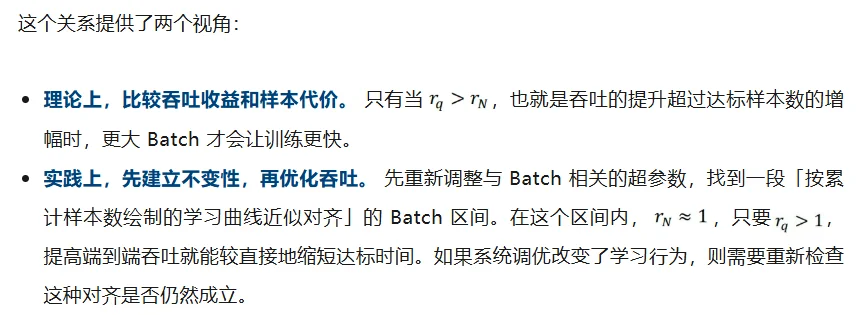
对大模型训练来说,最终目标不是把 Batch 开到最大,也不是让某个局部阶段跑到最快,而是让模型尽早达到要求的能力水平。论文用 Time-to-target 衡量这个目标:从训练开始,到模型首次达到预设验证目标,真实经过了多少时间。
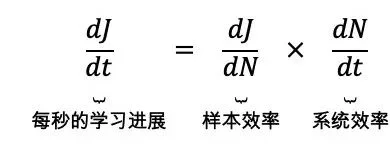
达标速度由两种效率共同决定:
设 J 表示验证表现,N 表示累计训练回答数,t 表示真实时间。沿着一条平滑近似的学习轨迹,有:
Takeaway:
Batch Size Invariance 有一个很直接的含义:如果 Batch 扩大一倍,模型达到相同效果所需的优化器更新次数应大致减半,因而总样本需求基本不变。
换句话说,在为不同 Batch 分别调好学习率等配套超参数后,一个合理且符合 Scaling 直觉的公平比较应满足:更多样本带来更好的性能,而累计消耗相同数量的样本时,不同 Batch 应达到近似相同的性能。
但这不会自动发生:更大 Batch 用更多回答平均梯度,却也让模型在固定样本预算内失去了一部分更新机会。要保持每样本学习效果,必须重新调节每次更新能走多远。
对 Adam 优化器,团队用平方根规则作为学习率调整的起点:
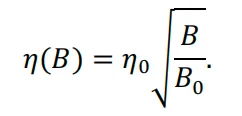
这个规则只是调参起点,需要用实验验证。论文只改变学习率,保持其他优化器超参数不变;联合调整更多超参数,可能进一步提高不变性,但这留待后续研究。
为让这一比较尽可能干净,论文在自研训练系统上评估 GRPO 和 PPO。两类实验都对每个 rollout batch 只做一次全局优化器更新,不拆 minibatch,也不重复使用 rollout,从而避免引入 minibatch size 和优化 epoch 等额外调参维度。
发现一:GRPO 在 16 倍 prompt batch 范围内近似不变
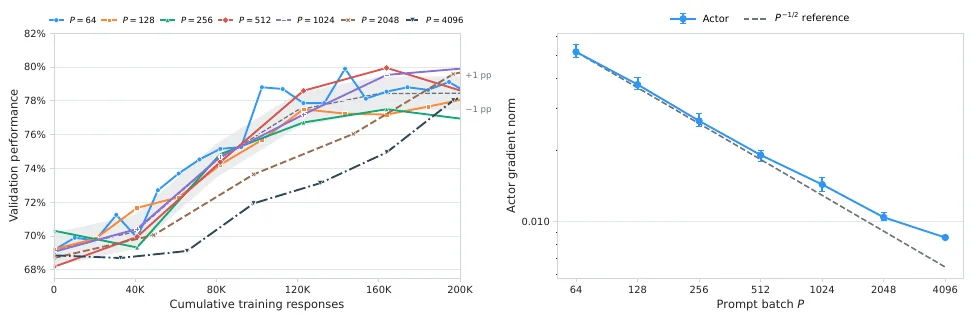
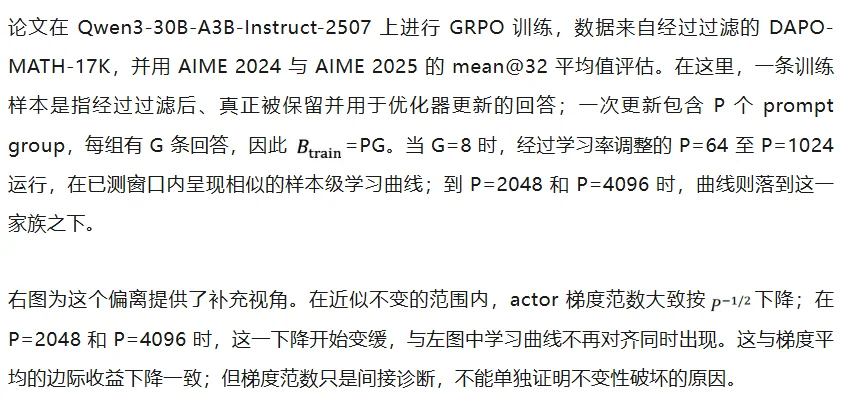
图 3|在固定 group size 下,调整学习率后,GRPO 在一段有界范围内呈现近似对齐的学习曲线。最大的几组 Batch 开始偏离,actor 梯度范数的下降也逐渐趋缓。灰色的 ±1 个百分点区间只是视觉参考,不是置信区间。图源:论文 Figure 2。
发现二:PPO 中 actor 和 critic 的尺度不同
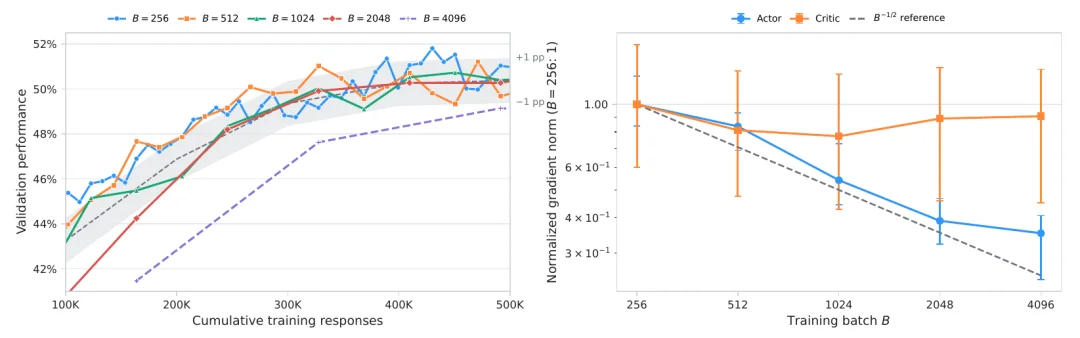
图 4|PPO 的 Batch Scaling。左图为验证表现与累计训练回答数的关系;右图为 actor 和 critic 梯度范数随 Batch 的变化。样本轴排除了起始 30 步只训练 critic 的 warm-up,并从 actor 开始训练时计数。图源:论文 Figure 5。
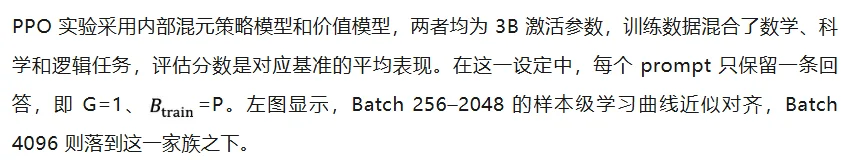
右图则显示了 actor 和 critic 的差异。随着 Batch 增大,actor 梯度范数持续下降,在最大 Batch 处趋于平缓;critic 梯度范数则相对平坦,波动也更大。由于两者的训练目标不同,它们可能拥有不同的有效 Batch 尺度,未来可以考虑分别分析和调优。
发现三:GRPO 的 Batch 更应看总回答数
GRPO 中,扩大 Batch 有两个方向:增加 prompt 数,或者增加每个 prompt 的回答数。更大的回答 Batch 可以通过平均更多样本降低梯度估计的方差,但这两条路并不完全等价:同一 group 内的回答共享 prompt,并通过组内相对奖励构造 advantage。
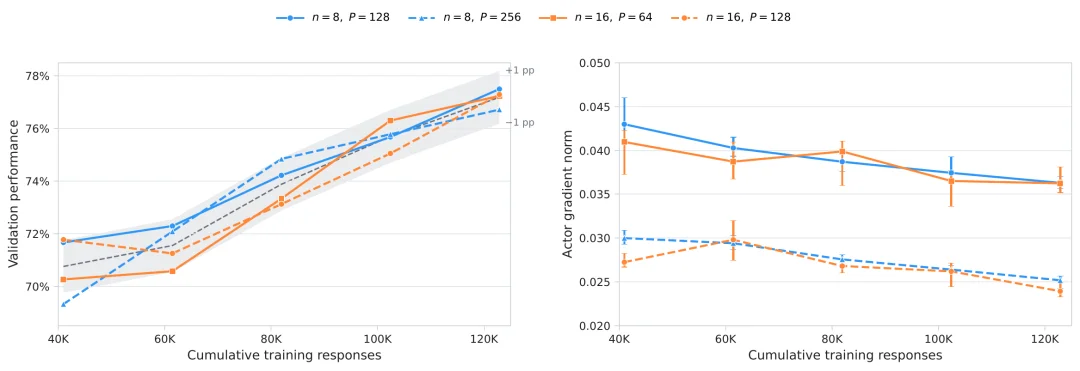
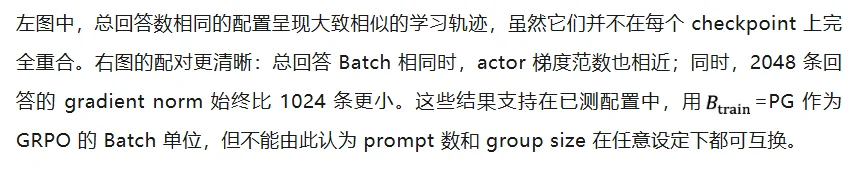
图 5|GRPO 的 group-size 对照。左图是验证表现与累计训练回答数的关系;右图是同一训练窗口内的 actor 梯度范数。实线对应每次更新 1024 条回答,虚线对应 2048 条;蓝色和橙色分别表示 group size 为 8 和 16。图源:论文 Figure 4。
论文比较了两组总 Batch 相同的配置:(P,G)=(128,8) 与 (64,16) 每次更新都使用 1024 条回答;(256,8) 与 (128,16) 则都使用 2048 条。图中以 n 表示 group size,对应本文正文里的 G。
发现四:保持学习率不变,会破坏近似不变性
实践中,增加 GPU 往往会同时扩大数据并行度和全局 Batch。如果学习率等超参数仍沿用小 Batch 的配置,训练未必会发散,甚至可能因为梯度噪声更小而显得更加平稳。但在消耗相同数量的回答时,大 Batch 完成的参数更新次数更少,模型未必能达到相同性能。
换言之,训练稳定不代表 Batch Size Invariance 仍然成立;为了追上小 Batch,它可能需要消耗更多回答。
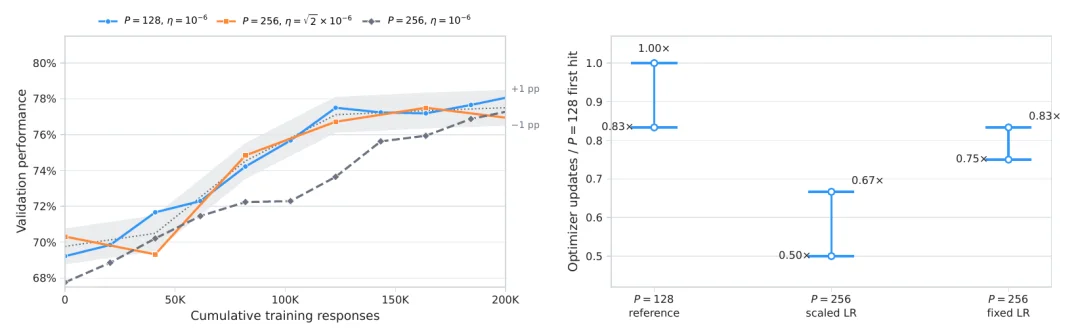
图 6|GRPO 的学习率对照。左图展示参考 Batch、平方根学习率调整后的翻倍 Batch,以及保持学习率不变的翻倍 Batch;右图展示达到目标所需的更新次数,并按参考配置归一化。端点区间反映的是评估 checkpoint 的粒度,不是置信区间。图源:论文 Figure 3。
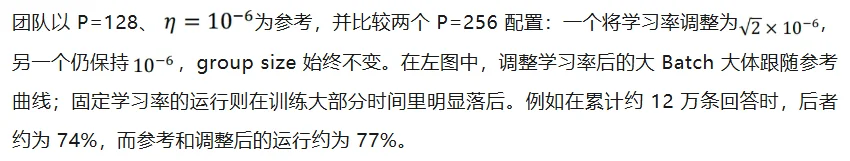
右图进一步量化了更新次数。如果精确满足 Batch Size Invariance,Batch 翻倍后的达标更新数应是参考配置的 0.50 倍。学习率调整后的配置位于 0.50–0.67 倍,与这一理想值基本一致;固定学习率配置则需要 0.75–0.83 倍的更新。由于每次大 Batch 更新消耗两倍回答,后一区间实际对应参考配置 1.50–1.67 倍的样本消耗。
Takeaway:
在每样本学习效果近似保持之后,下一个问题是如何更快处理这些样本。常见做法是增加 GPU,并扩大数据并行;但如果硬件数量不变,更大 Batch 是否也能加速?LLM 强化学习中的机会,来自生成与训练的计算不对称。
一个简化的局部模型可以描述这种差异:
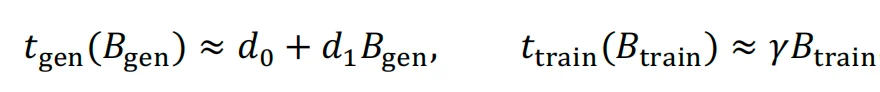
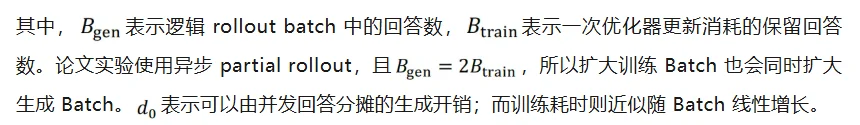
论文还通过 Roofline 视角进一步解释了这个直觉:Batching 会改变算术强度,也会改变执行处于内存带宽瓶颈还是计算瓶颈。上面的简化模型,概括的就是这种生成与训练的成本差异。
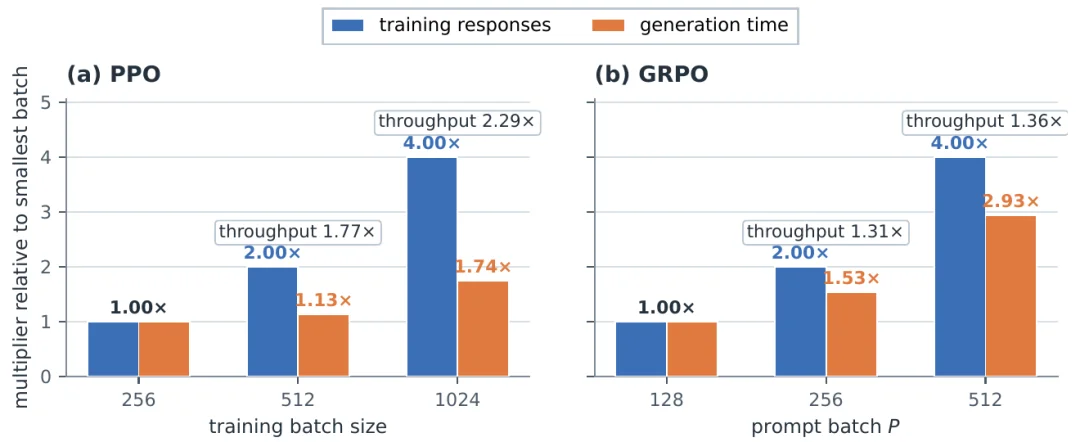
图 7|在固定硬件上,更多回答不一定需要按比例增加收集时间。Batch 增长 4 倍时,PPO 的生成阶段吞吐提高到 2.29 倍,GRPO 提高到 1.36 倍。这些是生成阶段的测量,不是端到端训练加速。图源:论文 Figure 6。
图 7 同时展示了回答数和收集时间相对最小 Batch 的倍数;蓝色回答数增长得比橙色耗时更快,两者的比值就是生成阶段的吞吐收益。在 PPO 中,训练 Batch 从 256 增加到 1024,回答数增长为 4 倍,收集时间却只从 39 秒增加到 68 秒,因此回答收集吞吐提高为 4/(68/39)=2.29×。
在 GRPO 中,P 从 128 增加到 256 时,生成阶段吞吐提高 1.31 倍;增加到 512 时,提高 1.36 倍。从 256 到 512 的额外收益已很小,说明在已测范围内,可利用的生成吞吐收益正在趋于饱和。
阶段结论:
上面的结果揭示了 LLM 强化学习 Batch Scaling 中两条不同的边界:
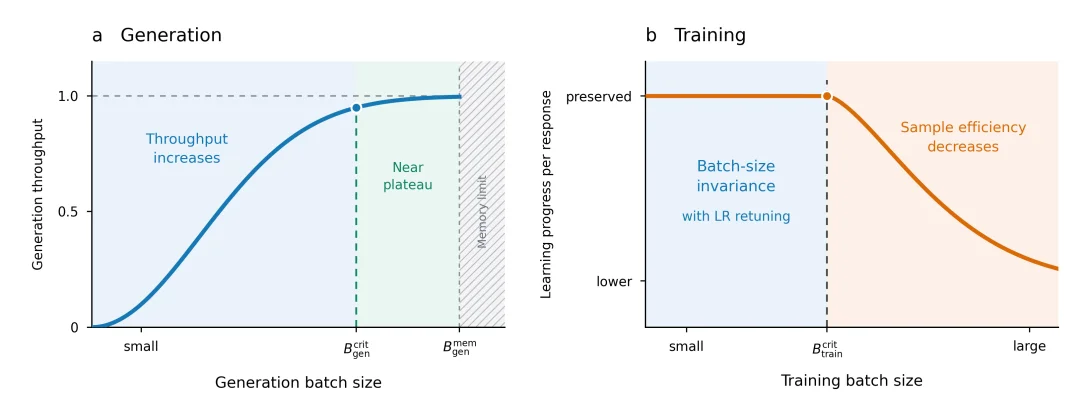
图 8|两种 critical batch。左图:生成吞吐随 Batch 增大逐渐接近平台,显存容量构成独立的可行性约束。右图:经过学习率调整后,每条回答的学习效果在一段范围内近似保持,然后在更大 Batch 下下降。两条横轴相互独立,两个边界不必重合;曲线均为示意。
两个边界之所以要分开,是因为它们回答的是两个不同问题:生成侧还有多少硬件吞吐可以挖掘,以及训练侧还能否保持每条回答的学习效果。显存容量还可能在到达吞吐平台之前限制可行 Batch。但任何一个边界都不能单独给出最快配置:如果生成 Batch 和训练 Batch 沿同一个尺度 B 一起增大,它们的相对顺序会通过「样本代价 —— 端到端吞吐」之间的平衡,塑造不同的达标时间曲线。
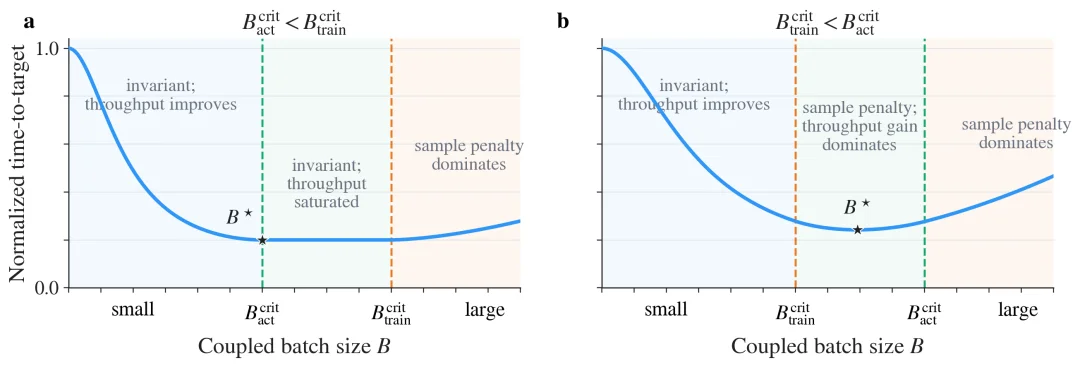
图 9|生成 Batch 和训练 Batch 联动扩展时,time-to-target 的两种可能情形。左图:生成吞吐先饱和,在样本效率开始下降之前出现一段近似最优的平台。右图:学习效率先下降,但吞吐收益暂时仍能补偿额外样本,因而示意最优点位于不变区间之外。曲线展示可能情形,不是对实验数据的拟合。
图 9 可以分成三个运行区间:
当然,两个边界的顺序也可以反过来。如果学习效率先恶化,但生成吞吐还在快速提高,那么只要吞吐收益大于额外样本代价,更大 Batch 仍可能更快。因此,最终目标是最小化 time-to-target,而不是机械地选择某一个 critical batch。
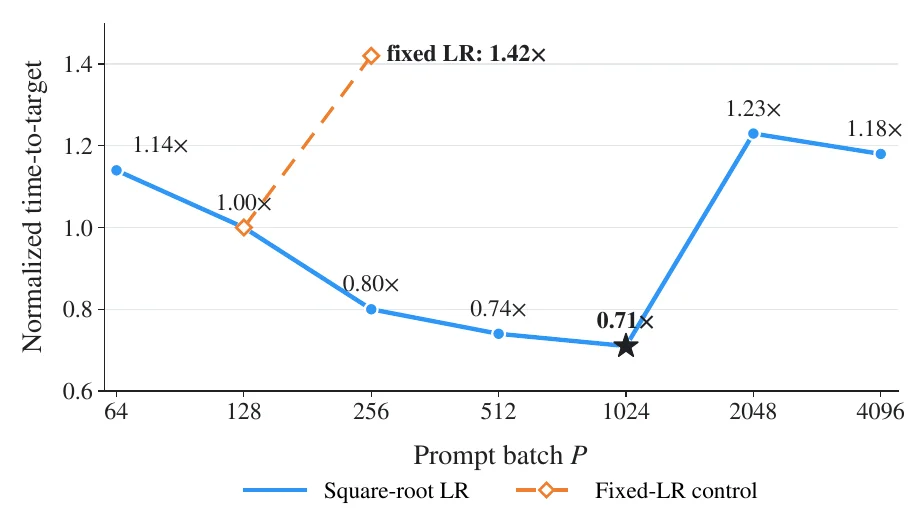
图 10|固定硬件上的 GRPO 归一化达标时间。每个 prompt 生成 8 条回答,蓝色点使用平方根学习率 Scaling,橙色对照保持学习率不变;所有时间均以 P=128 为参考归一化,星号标出已测配置中的最优点。图源:论文 Figure 8。
学习率重新调整后,将 P 从 128 增加到 512 和 1024,归一化 time-to-target 分别降至 0.74 倍和 0.71 倍。在 P=1024 时,模型与参考配置一样,用 122.88K 条保留回答达到目标,端到端吞吐提高 41%,训练时间从 11.90 小时下降到 8.42 小时,即不增加 GPU,达标时间缩短 29%。
但更大 Batch 并不总是更好。在 P=2048 和 P=4096 时,达标所需回答数增加约 60%,超过了 30% 和 36% 的吞吐收益,最终训练时间升至 1.23 倍和 1.18 倍。即使在 P=256 这样的中等 Batch,如果保持学习率不变,吞吐只提高 17%,达标回答数却增加 67%,训练时间变为参考配置的 1.42 倍。真正决定结果的,始终是吞吐收益能否补偿额外样本代价。
将前面的判断落到实践,可以压缩为两步:
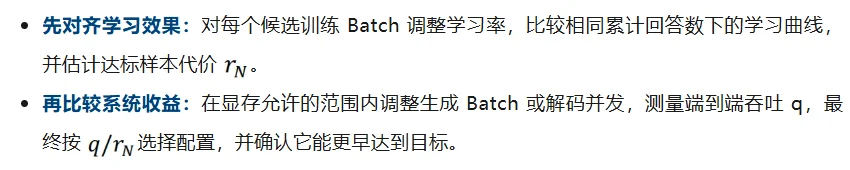
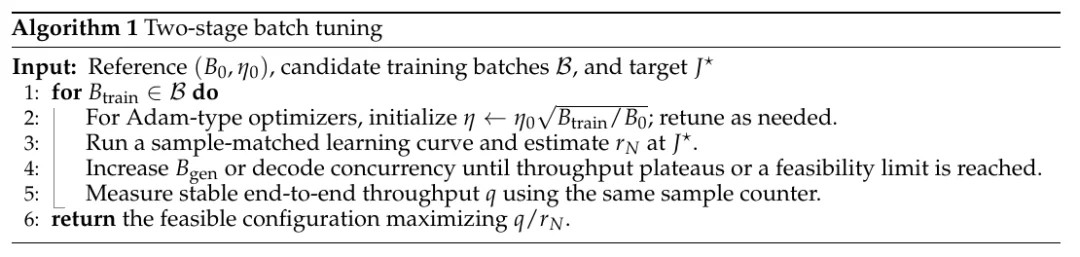
算法 1|论文中的 Batch 调优框架:先调整学习率并估计达标样本代价,再寻找生成并发带来的端到端吞吐收益,最后按达标时间选择配置。
这项工作的价值,不在于提出一种新的强化学习算法,而在于为已有的 GRPO 和 PPO 训练提供了一套简单、可扩展且 hardware-aware 的思考方式。具体来说,它带来四点启发:
这项研究把两个过去容易混在一起的问题拆开了:在使用同样多训练样本时,模型还能不能学得一样好;这些样本在给定硬件上能不能处理得更快。学习率 Scaling 可以在一定范围内维持近似 Batch Size Invariance,但这一规律最终会失效。若未来能提前预测这个有效范围,就有机会减少每换一个模型或任务都要重新摸索的成本。
改变 GRPO 或 PPO 的训练 Batch 时,应先配套调整学习率,检查相同累计回答数下能否达到相近效果;再提高生成并发,测量真正的端到端吞吐。换模型、换任务或换硬件后,可以复用这套调优顺序,但不能直接照搬上一次得到的 Batch 数值。
生成阶段通常受权重读取和内存带宽限制,更高并发可以分摊这部分成本;训练阶段的算术强度更高,更大的优化器 Batch 未必带来同等收益。因此,生成 Batch 与训练 Batch 不一定要同步扩大。将两者解耦、合理安排 GPU 分工,可能进一步释放吞吐,但也要避免等待过久造成数据过时、进而破坏学习行为。
各组先分别调好学习率等 Batch-dependent 配置,再看两个问题:用了同样多的样本,谁学得更好;达到同一个能力目标,谁花的时间更少。只比较相同更新步数后的分数,可能把「看过更多样本」误当成「学得更好」;只比较吞吐,也可能把「处理得更快」误当成「训练完成得更早」。
这些结论也有清晰边界。当模型、奖励、任务分布、训练阶段、推理引擎或执行策略发生变化时,样本效率与系统吞吐都可能改变,已经测得的有效 Batch 范围不能直接照搬。后续一个自然方向,是超越「只调学习率」的当前设定,寻找其他 Batch-dependent 超参数的迁移规则;PPO 实验还提示,actor 和 critic 可能需要不同的 Batch 尺度。
文章来自于"机器之心",作者 "机器之心"。


【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】graphrag是微软推出的RAG项目,与传统的通过 RAG 方法使用向量相似性作为搜索技术不同,GraphRAG是使用知识图谱在推理复杂信息时大幅提高问答性能。
项目地址:https://github.com/microsoft/graphrag
【开源免费】Dify是最早一批实现RAG,Agent,模型管理等一站式AI开发的工具平台,并且项目方一直持续维护。其中在任务编排方面相对领先对手,可以帮助研发实现像字节扣子那样的功能。
项目地址:https://github.com/langgenius/dify
【开源免费】RAGFlow是和Dify类似的开源项目,该项目在大文件解析方面做的更出色,拓展编排方面相对弱一些。
项目地址:https://github.com/infiniflow/ragflow/tree/main
【开源免费】phidata是一个可以实现将数据转化成向量存储,并通过AI实现RAG功能的项目
项目地址:https://github.com/phidatahq/phidata
【开源免费】TaskingAI 是一个提供RAG,Agent,大模型管理等AI项目开发的工具平台,比LangChain更强大的中间件AI平台工具。
项目地址:https://github.com/TaskingAI/TaskingAI
【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0
