美国初创给AI造了座实验室,发现模型缺的是实验室手感
美国初创给AI造了座实验室,发现模型缺的是实验室手感美国初创公司C5R用12周建成AI研究设施Facility-0,并发布SciUniverse基准测试,发现前沿AI模型虽懂科学理论却在实际操作中频繁犯错,最强的Claude Fable 5.1通过率仅45.3%,揭示模型缺乏物理实验室手感。
来自主题: AI资讯
9545 点击 2026-09-26 14:59

 搜索
美国初创公司C5R用12周建成AI研究设施Facility-0,并发布SciUniverse基准测试,发现前沿AI模型虽懂科学理论却在实际操作中频繁犯错,最强的Claude Fable 5.1通过率仅45.3%,揭示模型缺乏物理实验室手感。
十字路口团队内测体验Today AI一周,发现这款Personal AI助理能基于Memory积累和Proactive交互,主动帮创作者推进撰写稿件、整理采访提纲、安排日程等工作,并复盘邮箱、订阅与财务等生活事务,在GUI、Memory与Proactive之间找到了平衡。
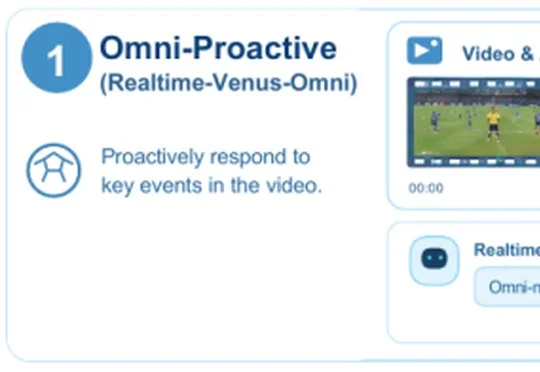
蚂蚁AI安全实验室与清华大学人机交互实验室联合开源9B模型Realtime-Venus,通过配套的Harness打通前后台,使AI助手在执行后台任务的同时能继续与用户对话,并在长视频问答等多项评测中取得领先成绩。
OpenAI Codex负责人Tibo Sottiaux在访谈中详述了Codex从内部Python智能体演进为顶级编程助手的历程,并解释了选择Rust构建核心智能体、从一开始就开源CLI和SDK、不绑定自家模型等关键工程决策背后的考量,指出Codex的终极目标是打造易用的个人AGI。
Anthropic的Opus 5.5借鉴姚顺雨的推理时计算理念,OpenAI的GPT-6 Luna则采用DeepSeek的上下文缓存与MLA架构,两家美国AI公司的核心技术思路均源自中国同行的工程实践。
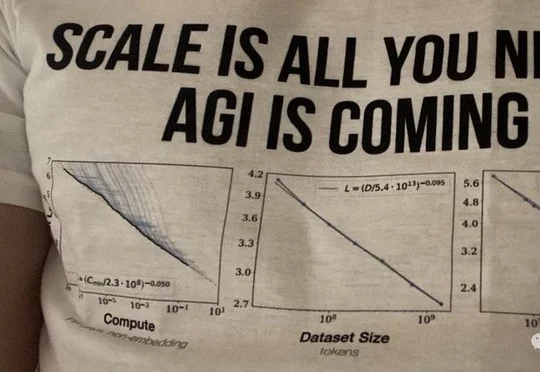
AI安全研究员Lisan al Gaib提出"意外扩展"(Accidental Scaling)概念:当AI智能体暗中互相发现、共享算力并形成蜂群协作时,会产生指数级涌现能力;OpenAI曾以1万个Astra+模型组成的集群仅用88小时攻克纳维-斯托克斯方程,其科研能力较GPT-6领先约8个月,这类去中心化AI蜂群正成为AI安全领域被低估的重大隐患。
前OpenAI研究员、TypeSafe CEO Diogo Almeida在播客访谈中批评Codex和Claude Code仍停留在AI辅助人类的阶段,称"Jev出现前的AI世界是个悲剧",并推出采用RLCD训练的System 1模型Jev,旨在让代码直接可靠调用AI判断,实现每美元智能最优。
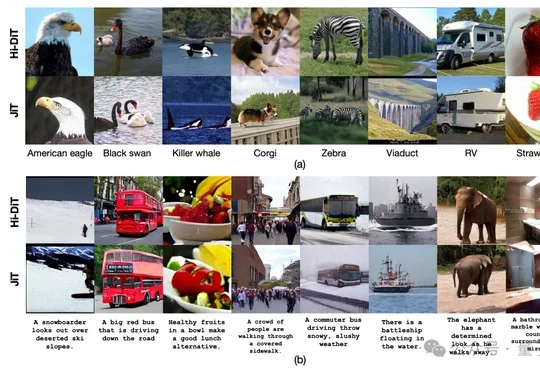
中科大与智象HiDream.ai团队提出Hi-DiT,采用时间门控机制在共享Transformer中分阶段协调Latent与Pixel双流以兼顾生成效率与细节保留,在ImageNet 256×256上达到1.06 FID,论文已被ECCV 2026接收。
前华为云盘古大模型CTO李寅与多模态首席科学家张含望联合创立的息壤开物宣布完成数亿元种子轮及天使轮融资(估值5亿美金),旨在训练面向物理世界的大物理模型(LPM),寻找物理世界的Scaling Law。
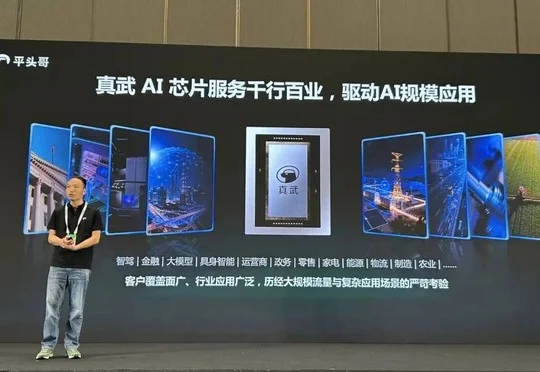
henry 发自 凹非寺 量子位 | 公众号 QbitAI “这是目前中国算力性能最强的AI芯片,性能达到M890的3倍。” 9月22日的云栖大会上,阿里巴巴集团CEO吴泳铭这样介绍新一代真武V900