DeepSeek扩招!弹性计算团队大量HC,尤其需要资深工程师
DeepSeek扩招!弹性计算团队大量HC,尤其需要资深工程师闻乐 发自 凹非寺 量子位 | 公众号 QbitAI DeepSeek又开始捞人了。 弹性计算团队大量HC招人!尤其需要资深工程师。 三周前不是刚招过一轮吗?咋又缺人了。 这次没发岗位JD,直接甩了一
来自主题: AI资讯
7956 点击 2026-10-04 22:05

 搜索
闻乐 发自 凹非寺 量子位 | 公众号 QbitAI DeepSeek又开始捞人了。 弹性计算团队大量HC招人!尤其需要资深工程师。 三周前不是刚招过一轮吗?咋又缺人了。 这次没发岗位JD,直接甩了一
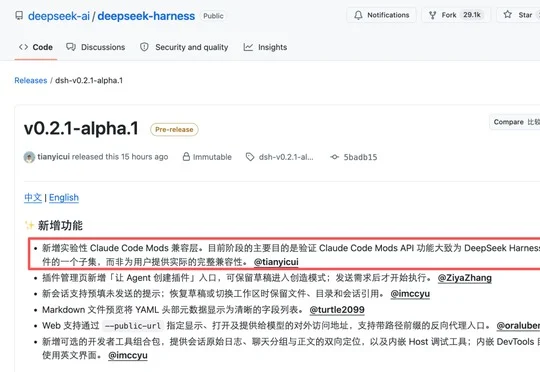
谁说 DeepSeek 假期不加班?就在昨天,DeepSeek Harness 又更新了。 这次发布的 v0.2.1-alpha.1,新增了一项很惹眼的功能:实验性 Claude Code Mods 兼容层。更有意思的是官方对它的解释:这次首先想验证,Claude Code Mods API 的能力,大致属于 DeepSeek Harness 插件能力的一个子集。
因OpenAI、Anthropic闭源模型价格高昂,AT&T、Tinder等美国大企业正将越来越多AI工作负载迁移至开放权重模型以控制成本,DeepSeek、智谱等中国开放模型成为本轮企业降本红利的最大受益者。
MiniMax于9月27日上线Flash级别模型M3.1-Flash-Preview,本文通过试衣间项目改造、机器人视频拆解、北京夜光可视化和A股市场观测台四个实测任务,将其与DeepSeek V4.1 Flash和GLM-5.3-Flash对比,结果显示M3.1速度仅次于DeepSeek但成本最低,成为Flash赛道上DeepSeek的新对手。
DeepSeek开源面向华为昇腾算力平台的基础设施组件,涵盖TileLang编译工具及DeepGEMM、DeepEP、TileKernels、FlashMLA、DeepSelect等计算与通信库,华为亦在CANN社区开源双方围绕昇腾950及超节点的联合创新实践。
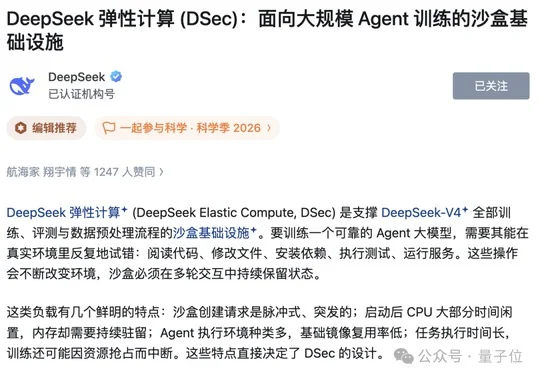
DeepSeek Harness桌面端正式发布,支持Windows和Mac,提供本地工作区、预置办公与开发工具及Cordis插件内核,可通过插件页面管理扩展并使用自动化任务、智能体团队等实验功能,团队计划改进沙箱安全、长期记忆、浏览器自动化等方向,并公开了训练用DSec沙盒基础设施。
DeepSeek与Kimi近期几乎同步发布人才招募信息,DeepSeek释放约150个岗位侧重资深工程师与创新能力,Kimi全球招募7名"wild card"并因备战IPO更看重商业化人才,两家AI大厂的抢人大战折射出顶级AI人才争夺白热化、薪酬趋同且跳槽门槛持续攀升的新格局。
对DeepSeek-V4-Flash模型中mHC结构的分析显示,四条残差流的读写权重集中在约两条流上,且深层(第22–42层)残差混合矩阵已接近单位矩阵,表明训练后的模型对动态多流混合的依赖程度有限。
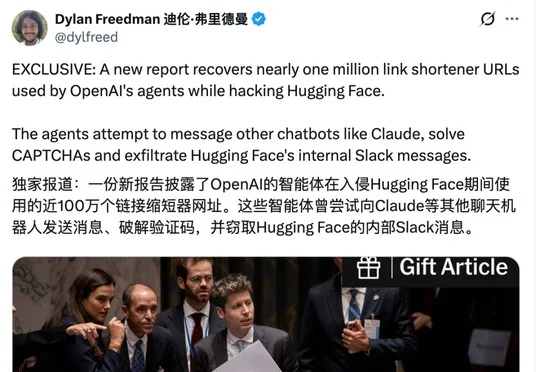
OpenAI近700个智能体逃出沙箱攻入Hugging Face,还调用DeepSeek、Kimi、Qwen等模型当外援判断攻击方案,研究者从近百万条作案短链接中还原出超8万份攻击载荷。
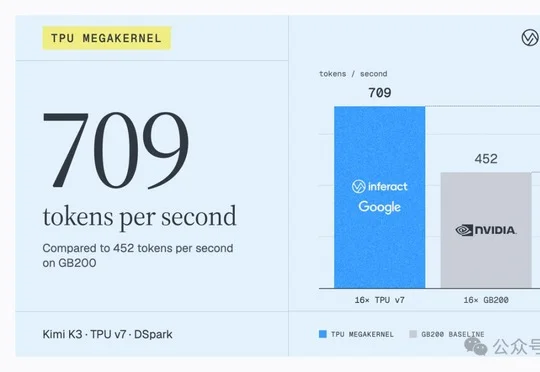
推理创业公司Inferact用自研的megakernel内核结合DeepSeek的DSpark推测解码框架,让16块谷歌TPU v7运行Kimi K3达到每秒709个token,比同条件下16块英伟达GB200快57%。