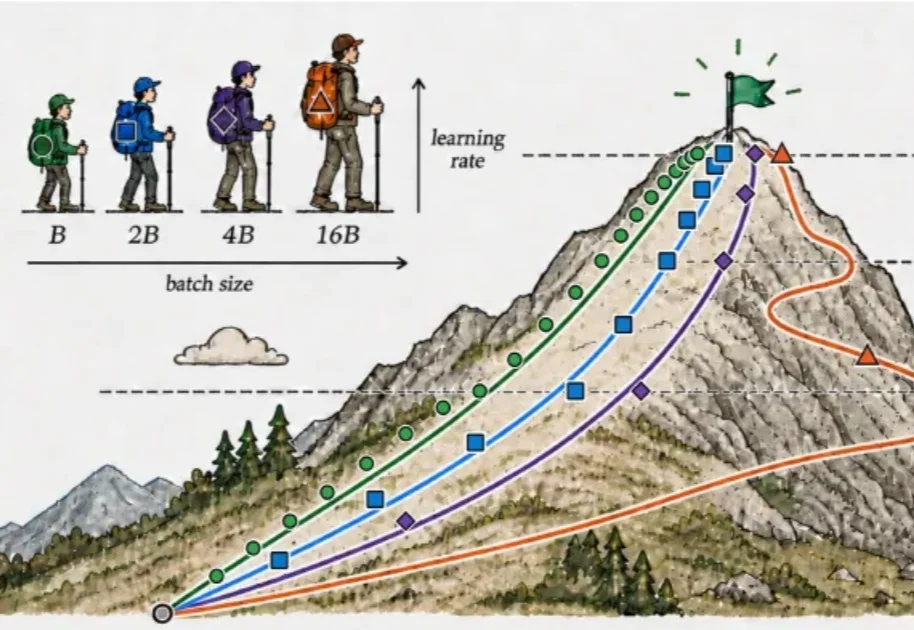
假如有一万张卡,RL训练该怎么扩大规模?十万张呢?
假如有一万张卡,RL训练该怎么扩大规模?十万张呢?当预训练将大模型带到新的能力起点,强化学习则通过持续的探索与反馈,不断激发模型在新环境、新任务中的推理与行动能力,决定它们还能走多远。
来自主题: AI技术研报
7572 点击 2026-09-22 14:43

 搜索
当预训练将大模型带到新的能力起点,强化学习则通过持续的探索与反馈,不断激发模型在新环境、新任务中的推理与行动能力,决定它们还能走多远。
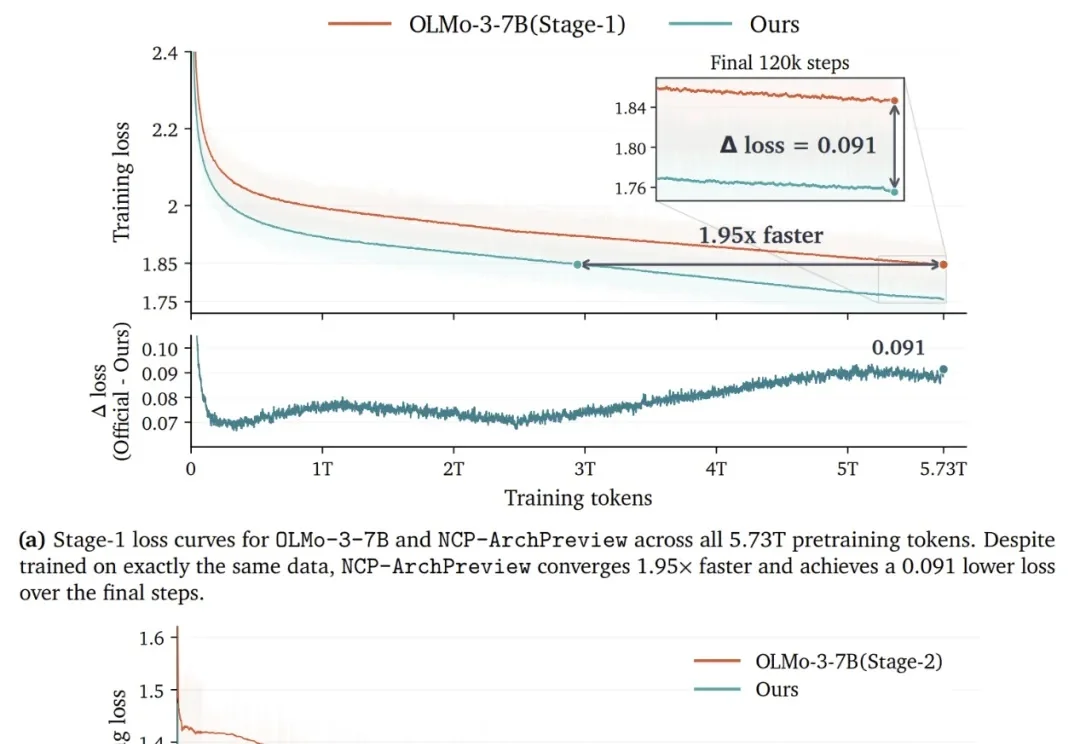
自现代大模型诞生以来,“下一个Token预测(Next-Token Prediction, NTP)”就被奉为不可撼动的黄金律条。然而,逼着模型逐字死记硬背,真能学会宏观语义规划吗?
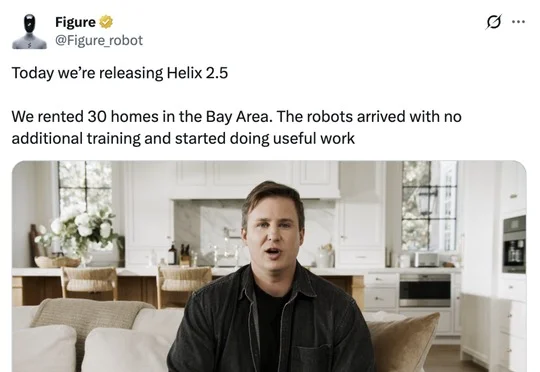
Figure AI发布新一代模型Helix 2.5,在30个从未采集过数据的湾区民宅中进行零样本测试,420次试验成功237次,零样本成功率达56%,较未经Index预训练的策略的9%提升超过522%。
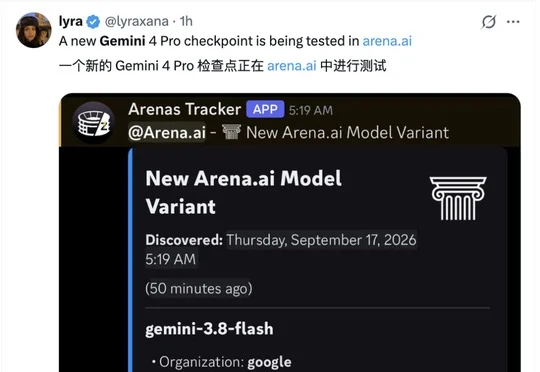
用户在Code Arena的battle模式中发现疑似Gemini 4 Pro新检查点(内部代号argon)伪装为gemini-3.8-flash进行盲测,据爆料其支持256K最大输出和2M上下文窗口,原定9月发布的Gemini 4 Pro已因预训练问题推迟至10月。
据雷峰网独家获悉,一位长期在英国工作的Google Gemini预训练专家(L7-L8级别)近期加入国内某互联网大厂,被视为本轮BAT高价争抢Gemini人才以来首次"找对了人";此前多家大厂虽从Gemini硅谷办公室挖角,但因Google有意将核心预训练人才留在DeepMind英国办公室,导致此前引入的部分人选并未触及预训练核心环节。

9月7日科大讯飞发布星火X2.5模型,基于万卡国产910B集群完成预训练和后训练,并使其具备在真实NPU环境中自主优化算子的能力,通过DSA算子案例经约1600次工具调用实现3.5倍加速,形成AI反哺国产算力的技术闭环。
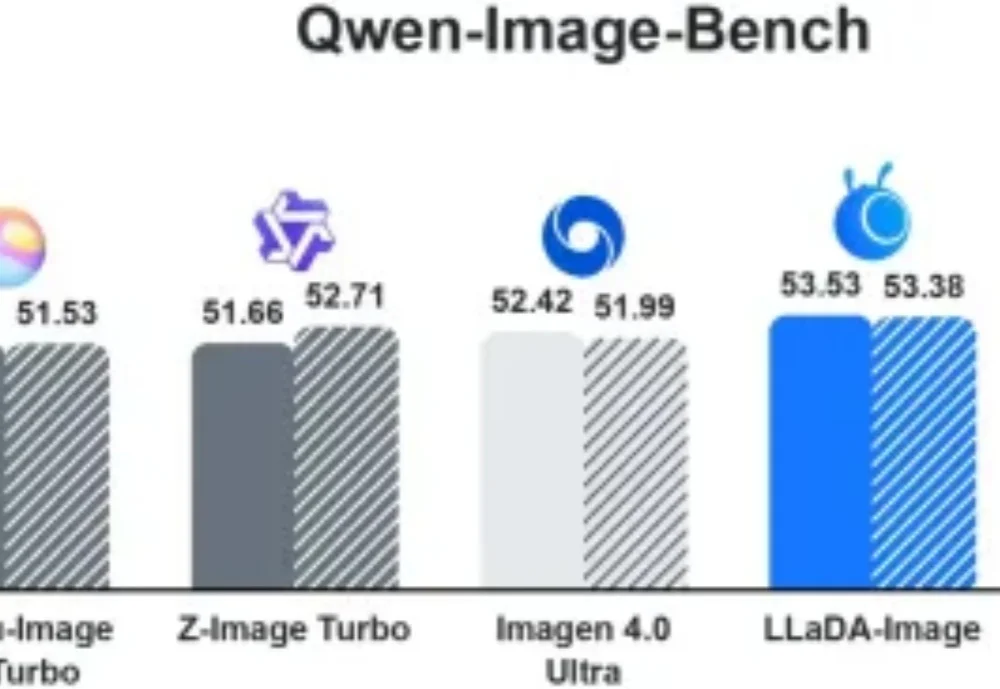
先学会画,再学会听话。 LLaDA-Image 在预训练和中期训练阶段直接从图片学习视觉先验,超过 90% 的累计生成训练样本采用 image-only 监督;图文对则集中用于后续语言对齐。模型权重、训练代码和完整配方同步开放。
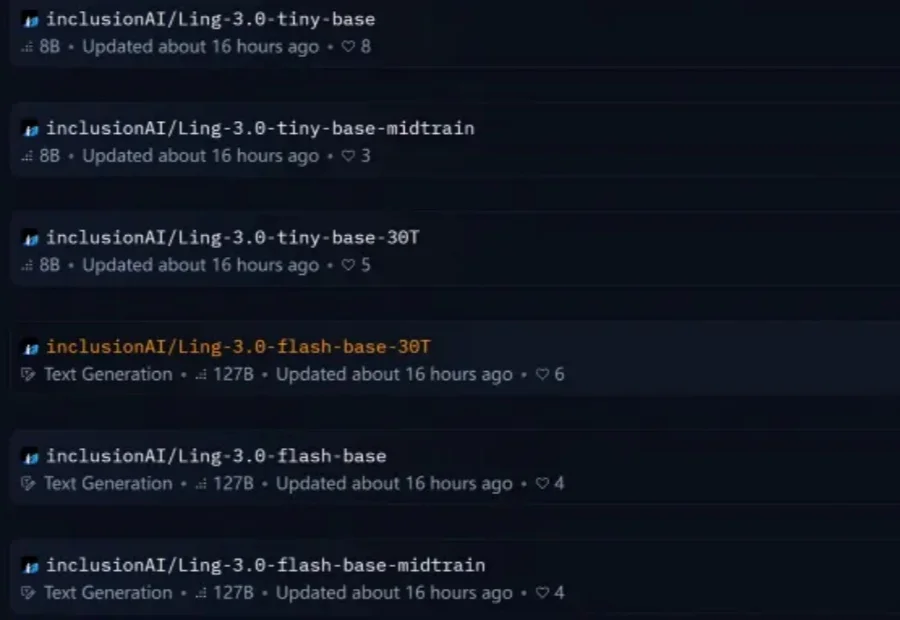
百灵为开发者提供了多个可继续训练的起点。今日,蚂蚁百灵开源Ling-3.0-tiny-base和Ling-3.0-flash-base。除最终Base模型权重外,团队还同步开放了两款模型的预训练和中期训练权重,共计6个checkpoints。
近期,字节跳动大模型核心部门Seed完成新一轮组织调整,调整核心集中在Seed Foundation Model(Seed基础模型)板块,新设四个一级部门,重构了预训练数据、强化学习与后训练的组织链路。

本文主要介绍来自该团队的最新论文 Teaching Vision-Language-Action Models What to See and Where to Look,目前该论文已经被 ECCV 2026 正式接收,相关代码和模型已全部开源。