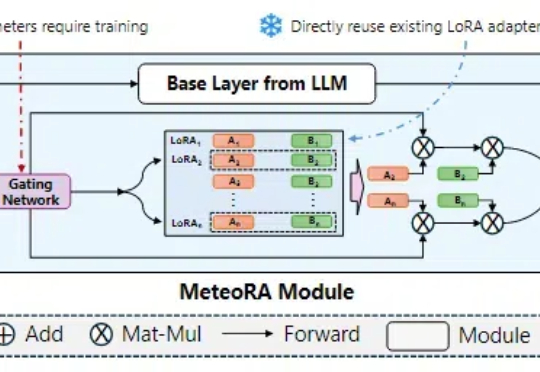
一次推理解决复合问题:基于MoE的大语言模型知识模块可扩展融合推理架构MeteoRA
一次推理解决复合问题:基于MoE的大语言模型知识模块可扩展融合推理架构MeteoRA在大语言模型领域中,预训练 + 微调范式已经成为了部署各类下游应用的重要基础。在该框架下,通过使用搭低秩自适应(LoRA)方法的大模型参数高效微调(PEFT)技术,已经产生了大量针对特定任务、可重用的 LoRA 适配器。
来自主题: AI技术研报
9749 点击 2025-02-22 13:57

 搜索
在大语言模型领域中,预训练 + 微调范式已经成为了部署各类下游应用的重要基础。在该框架下,通过使用搭低秩自适应(LoRA)方法的大模型参数高效微调(PEFT)技术,已经产生了大量针对特定任务、可重用的 LoRA 适配器。
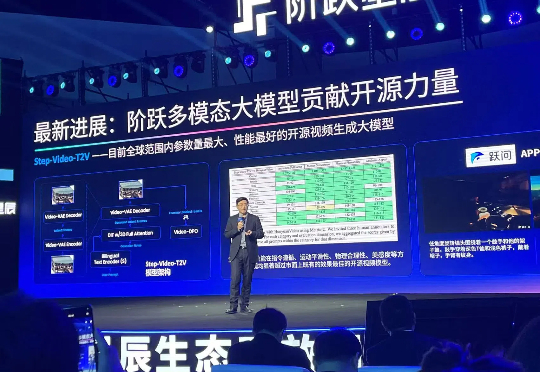
回应DeepSeek,阶跃星辰亮出“三件套”:开源,多模态推理,AI Agent。
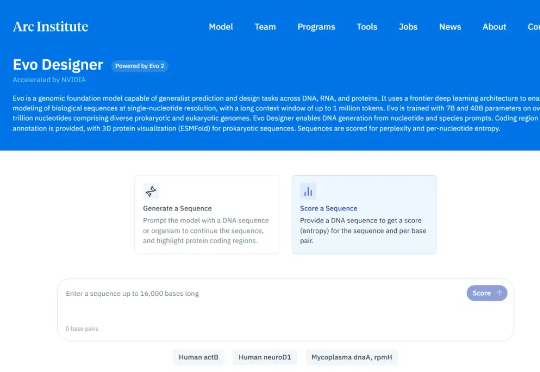
生物学大模型又迎新里程碑!2025 年 2 月 19 日,来自 Arc Institute、英伟达、斯坦福大学、加州大学伯克利分校和加州大学旧金山分校的科学家们,联合发布了生物学大模型 Evo2。
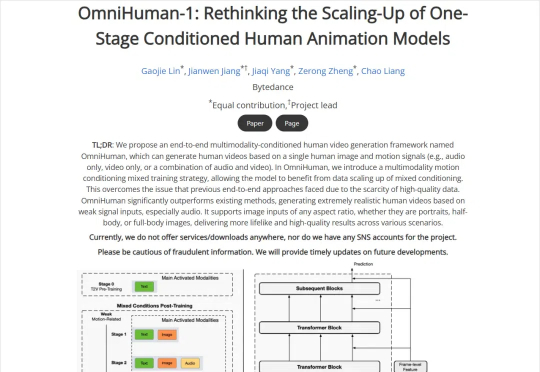
半个月前,字节的OmniHuman-1模型在全球的AI圈,都掀起了巨浪。可能有些朋友不知道这是个啥,我大概通俗易懂的解释一下 一张图+一段音频,就能生成超逼真的唇形同步AI视频。
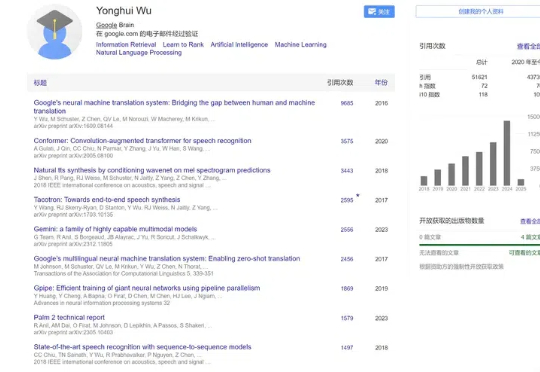
多位接近字节的人士对硅星人透露,字节的AI核心部门Seed正在快速调整定位和调兵遣将。刚刚从谷歌加入字节跳动的AI大牛、参与了Gemini开发的Google Fellow吴永辉博士,将成为Seed新的负责人,替换原LLM团队及Seed总负责人朱文佳,团队内部正在梳理调整汇报关系。
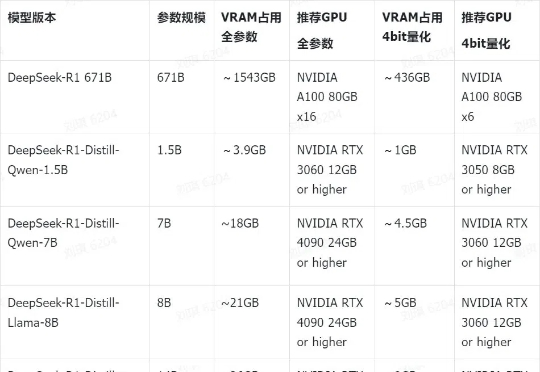
DeepSeek-R1及其蒸馏版本模型突破了AI Reasoning和大规模AI性能的新基准,其中DeepSeek-R1-Zero和DeepSeek-R1,已经在推理和问题求解上树立了新的标准。本次研究聚焦于如何利用已有的机器进行模型部署,使用这些先进的模型进行开发和研究。
美国AI云服务商Together AI宣布完成3.05亿美元B轮融资,估值高达33亿美元!该公司押注开源模型,提供包括DeepSeek-R1在内的200多个模型API服务,并出租GPU算力,年收入已超1亿美元。

Mercor,由三位 21 岁的 Thiel Fellows 创办的人工智能招聘初创公司,已在 B 轮融资中筹集了 1 亿美元,公司向 TechCrunch 确认了这一消息。
在AI计算资源日益稀缺的时代,Lambda凭借其独特的云GPU解决方案迅速崛起,成为资本市场的宠儿。最近,这家成立于2012年的AI云计算公司宣布完成4.8亿美元D轮融资,累计融资额达到8.63亿美元,跻身AI创投榜云科技赛道第二位,仅次于Coreweave。此次投资阵容强大,包括英伟达、AI技术大牛Andrej Karpathy,以及和硕、超微、纬创、纬颖等行业巨头的战略入股。
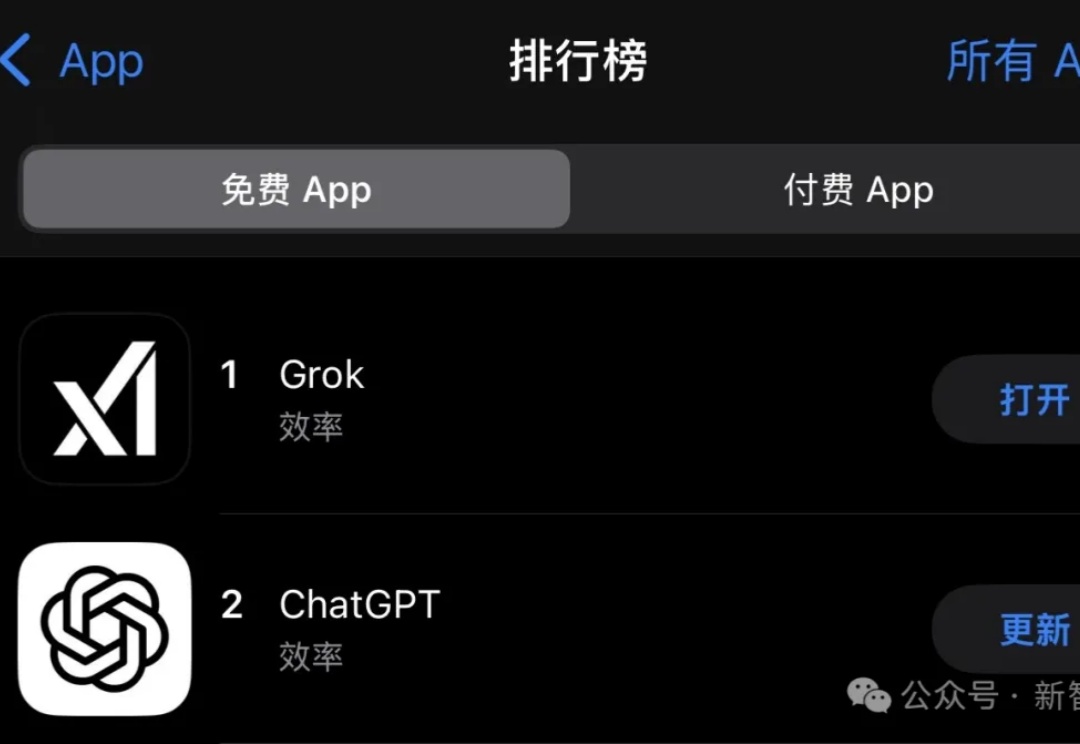
官宣免费后,Grok火速登顶美区App Store榜首,同时,xAI也放出官方博文,秀了一把模型的数学、代码、ASCII Art演示。最引人瞩目的两位C位华人,均来自多伦多大学,分别和Hinton、Bengio有交集。