扩散模型训练方法一直错了!谢赛宁:Representation matters
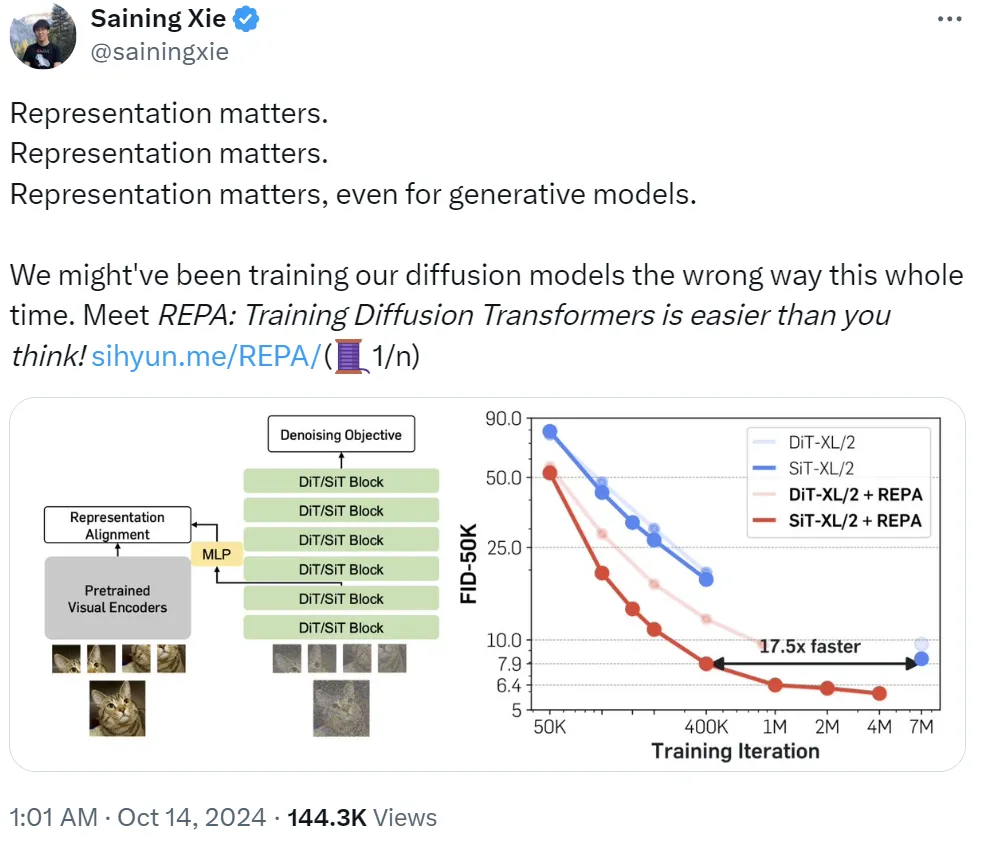
扩散模型训练方法一直错了!谢赛宁:Representation matters是什么让纽约大学著名研究者谢赛宁三连呼喊「Representation matters」?他表示:「我们可能一直都在用错误的方法训练扩散模型。」即使对生成模型而言,表征也依然有用。基于此,他们提出了 REPA,即表征对齐技术,其能让「训练扩散 Transformer 变得比你想象的更简单。」
搜索
是什么让纽约大学著名研究者谢赛宁三连呼喊「Representation matters」?他表示:「我们可能一直都在用错误的方法训练扩散模型。」即使对生成模型而言,表征也依然有用。基于此,他们提出了 REPA,即表征对齐技术,其能让「训练扩散 Transformer 变得比你想象的更简单。」
在 Claude AI 新模型发布之际,Anthropic 的CEO Dario Amodei 发表了一篇近2万字深度长文,探讨人工智能对人类的潜在积极影响。作为斯坦福大学神经科学博士,Amodei 以严谨的学术态度定义了"强人工智能"概念,并详细阐述了它在不同核心领域可能带来的积极变革。
自近日获知自己摘得诺贝尔物理学奖之后,76 岁的人工智能教父 Geoffrey Hinton 便「闲不住」了。
11x.ai 开发的人工智能“数字员工”如 Alice 和 Jordan,能够自动化处理销售开发、客户服务等重复性任务,帮助企业提升效率,降低成本,释放人力专注于更具战略价值的工作。客户可以根据完成的任务量或实际取得的销售成果进行付费,提供更定制化的服务。
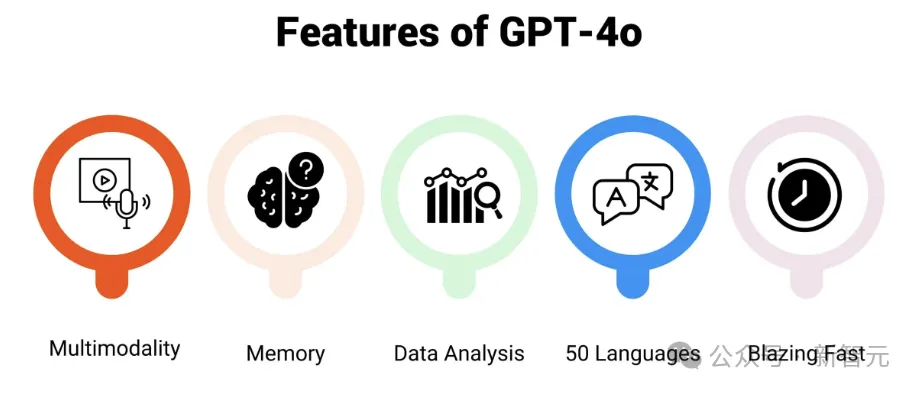
多模态大语言模型(MLLM)如今已是大势所趋。 过去的一年中,闭源阵营的GPT-4o、GPT-4V、Gemini-1.5和Claude-3.5等模型引领了时代。
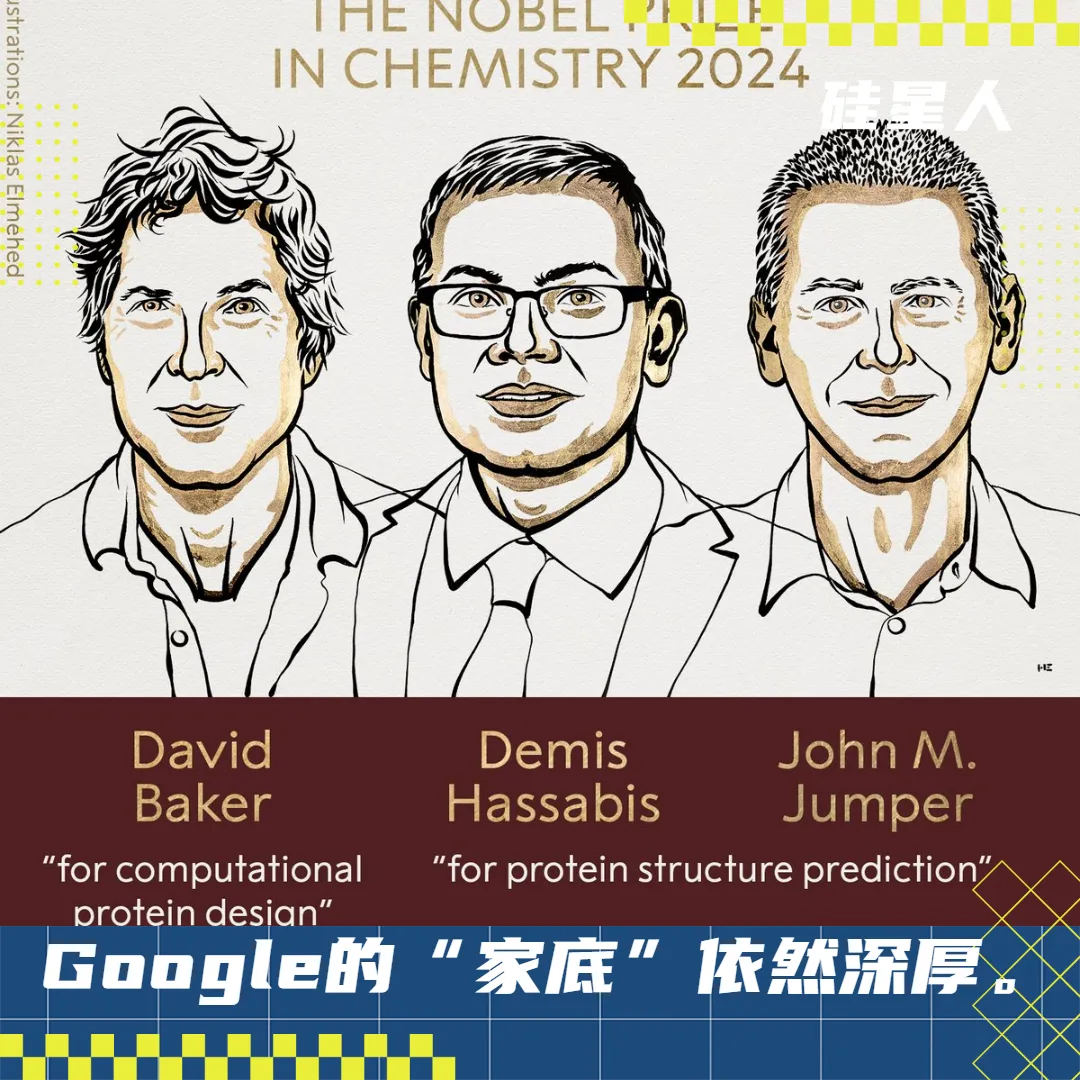
2024年的诺贝尔化学奖一半授予大卫·贝克(David Baker),“以表彰在计算蛋白质设计方面的贡献”;另一半则共同授予德米斯·哈萨比斯(Demis Hassabis)和约翰·M·詹珀(John M. Jumper),“以表彰他们在蛋白质结构预测方面的成就”。
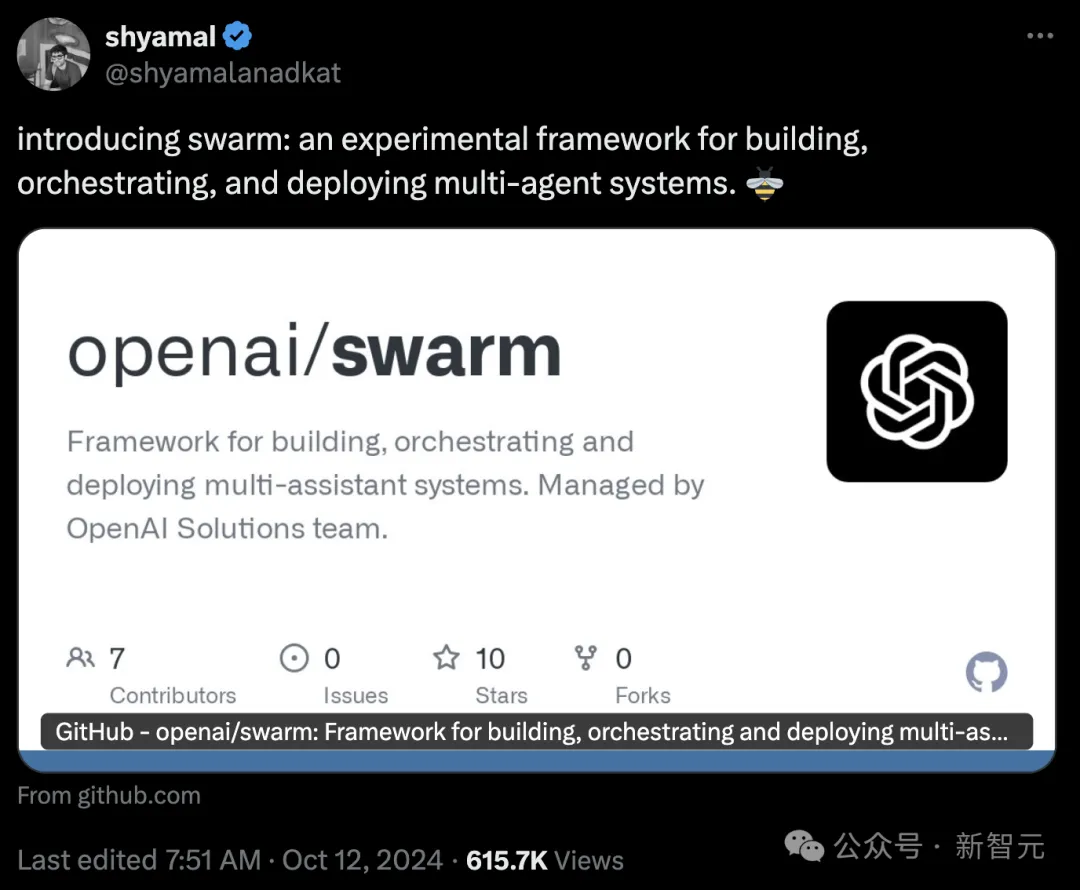
OpenAI好不容易开源了一次,却被曝出剽窃? 就在昨天,OpenAI应用AI研究员Shyamal Anadkat ,放出了全新多智能体框架——Swarm,瞬间在全网爆火。
三个月前我在硅谷沉浸式泡了两个多月把产品上的整体感受和几个趋势简短写在了这里,在和不同的创业者交流研究了 40 多个产品后,最终回归到了“语音”这个方向,写下“Voice is a big thing”,语音产品是我认为 AI 在 C 端领域的核心变革点。
微软、高通、苹果前高管加入, 人形机器人已实地测试。
GPT使用量在大幅上升。