AI 3D 卷向生产端:Lux3D 发布,3D 创业者的新工具来了!
AI 3D 卷向生产端:Lux3D 发布,3D 创业者的新工具来了!8 月 26 日,群核科技正式发布了 AI 3D 生成模型 Lux3D。它提供标准版、极速版和渲染器能力,还能通过 API、插件接入 Codex、WorkBuddy 等 Agent 及主流设计工作流。
来自主题: AI资讯
9462 点击 2026-08-30 12:00

 搜索
8 月 26 日,群核科技正式发布了 AI 3D 生成模型 Lux3D。它提供标准版、极速版和渲染器能力,还能通过 API、插件接入 Codex、WorkBuddy 等 Agent 及主流设计工作流。
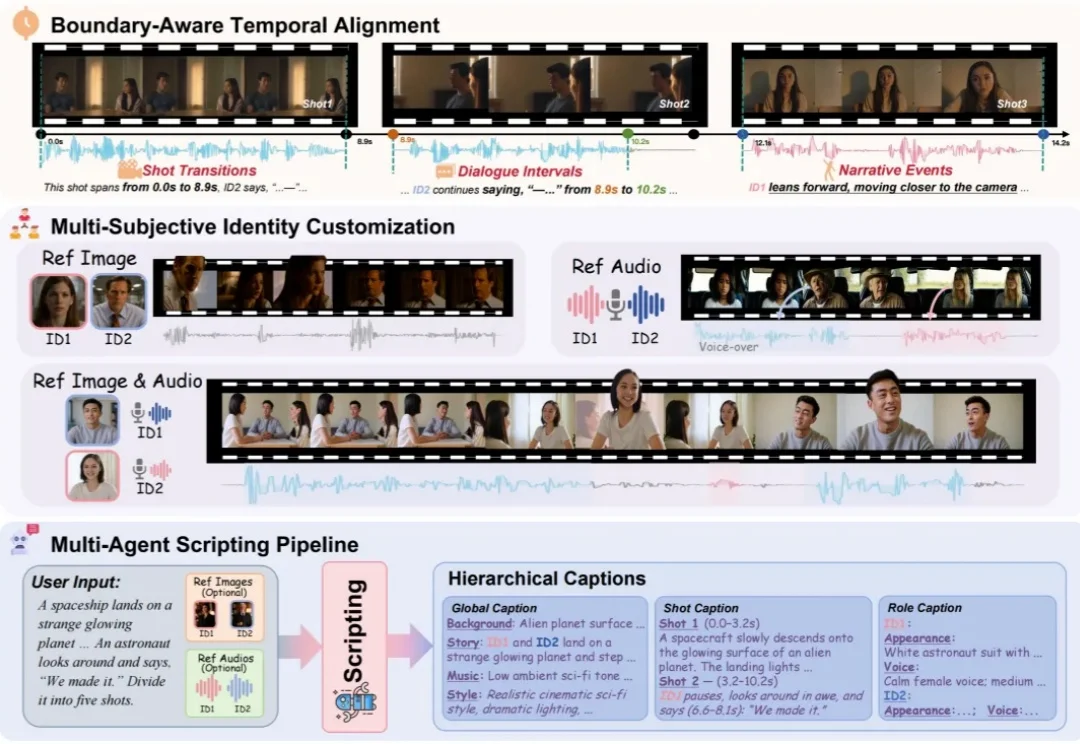
过去几年,视频生成模型在清晰度、运动表现和画面质感上不断进步。输入一句文字,模型已经能够生成颇具电影感的视频。
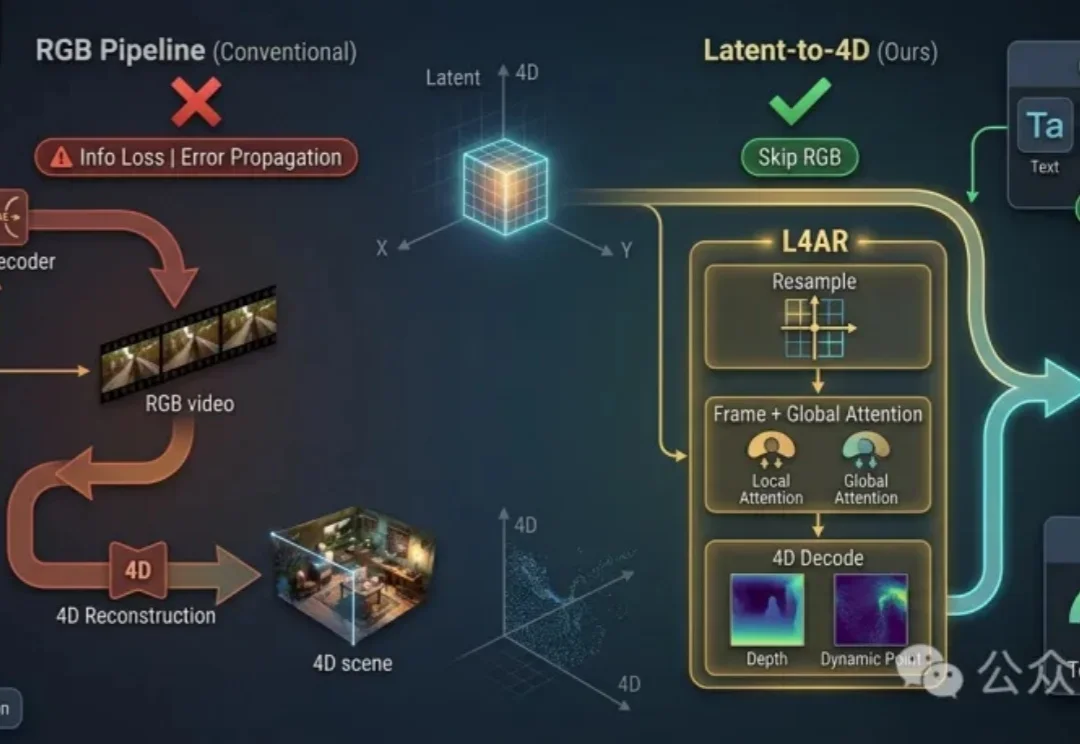
今天的视频生成模型,已经越来越像一个会拍电影的导演。
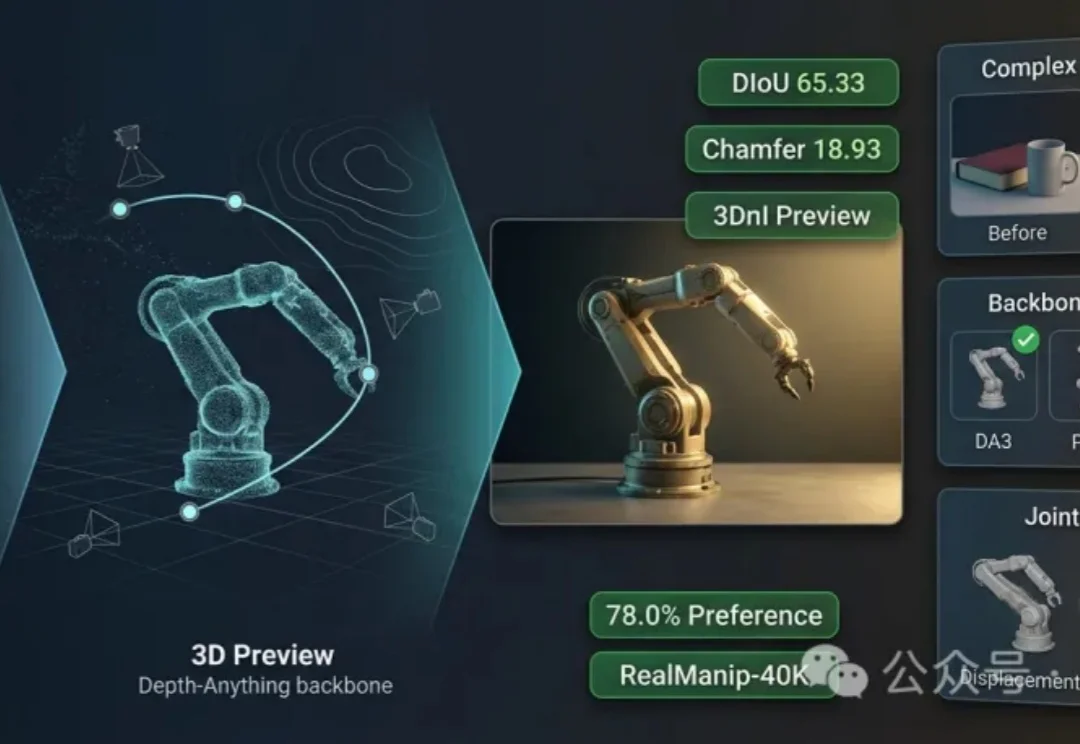
图像生成模型正从「会创作」转向「可操作」。
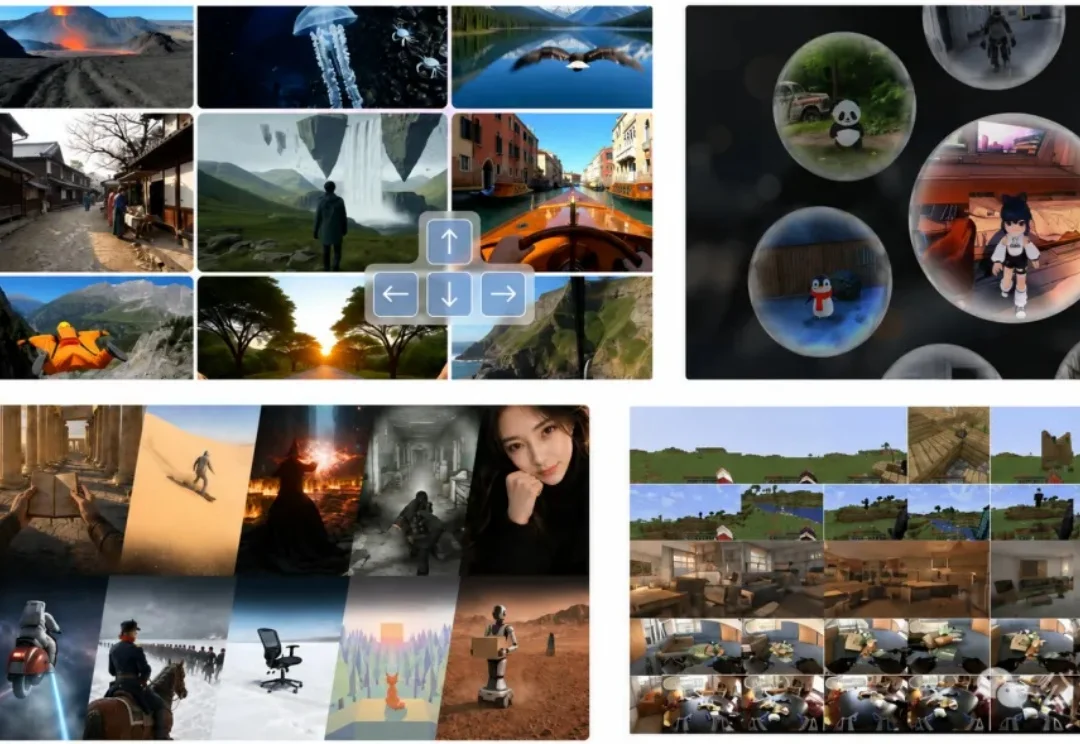
太卷了!过去两年,视频生成模型把画面参数几乎卷了个遍。
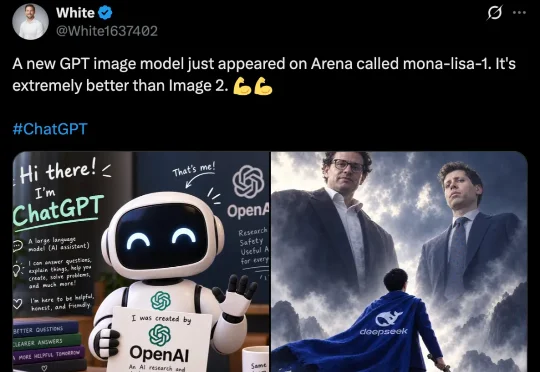
这两天,Arena 平台上突然出现一款神秘的图像生成模型,代号「mona-lisa-1」。有人让该模型「生成一张你的创造者的图片」,模型点名 OpenAI 和奥特曼。且有网友用 OpenAI 验证工具检测生成图片后,确认图片中带有 OpenAI 的 SynthID 水印。
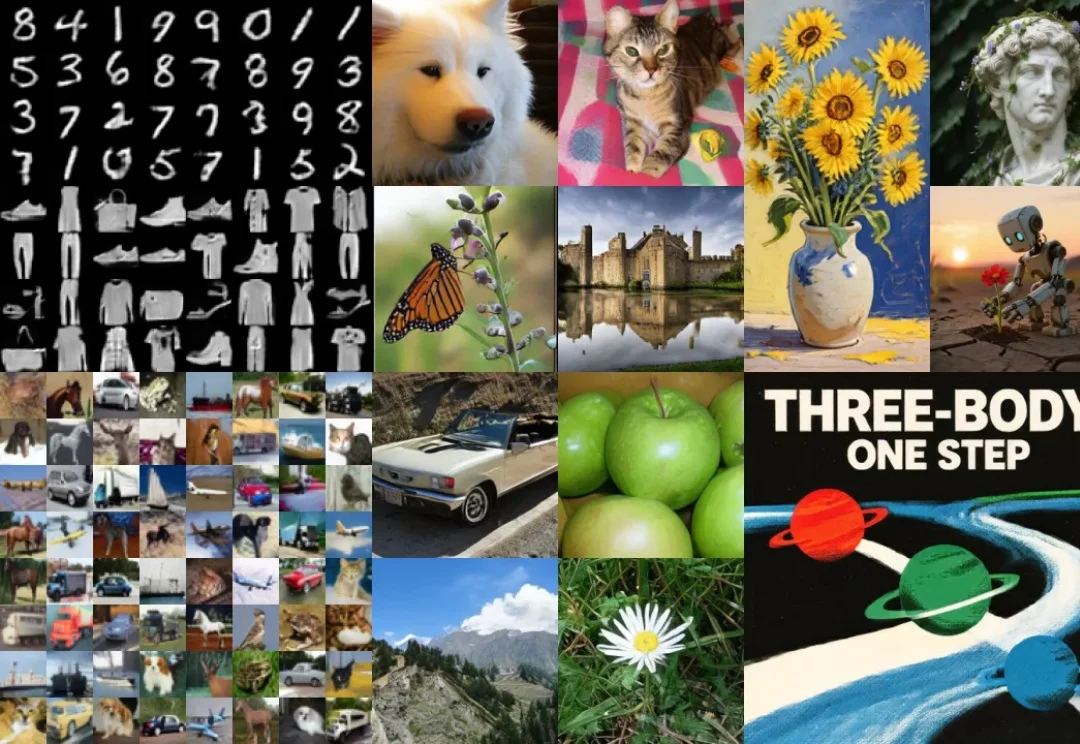
只做一次生成器前向,就能得到一张图,这是一步生成追求的效率。但想把采样步数降到 1,难题其实在训练端:怎样用足够稳定、简单的监督信号,让生成分布靠近真实分布?
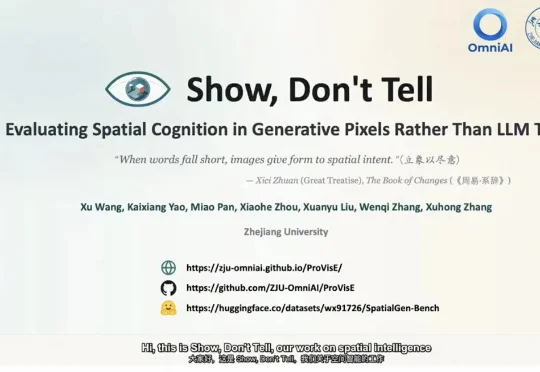
近日,浙江大学 OmniAI 团队在 《Show, Don’t Tell: Evaluating Spatial Cognition in Generative Pixels Rather Than LLM Text》 中提出 ProVisE,让图像生成模型直接在图中回答空间问题,并将视觉答案还原为原 benchmark 可以评分的结构化预测。
再牛的大模型,也要放到行业面前公开露个面,才算真交卷。
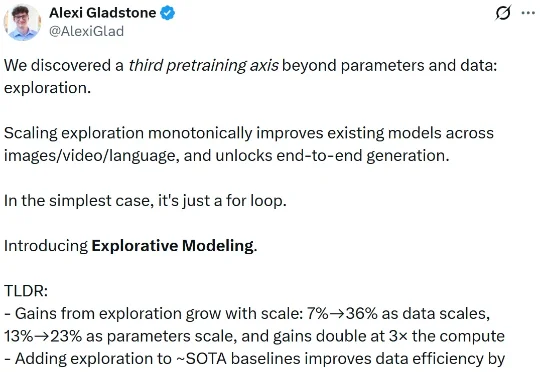
最近,一篇来自 UIUC 与哈佛大学的论文,试图把这块最后的拼图补上。作者给这个新范式起了个名字,叫 Explorative Modeling(探索式建模),模型简称 XM。它的想法简单到近乎朴素,却指向一个大胆的结论:生成模型除了参数和数据,其实还有第三根可以放大的轴。