注意!这个小球开始下山了
注意!这个小球开始下山了4年前的开源项目突然在Hacker News爆火,通过可视化的「小球下山」,帮助非专业和专业人士,更好地理解AI训练中梯度下降的过程。
来自主题: AI资讯
8917 点击 2024-05-23 21:16

 搜索
4年前的开源项目突然在Hacker News爆火,通过可视化的「小球下山」,帮助非专业和专业人士,更好地理解AI训练中梯度下降的过程。
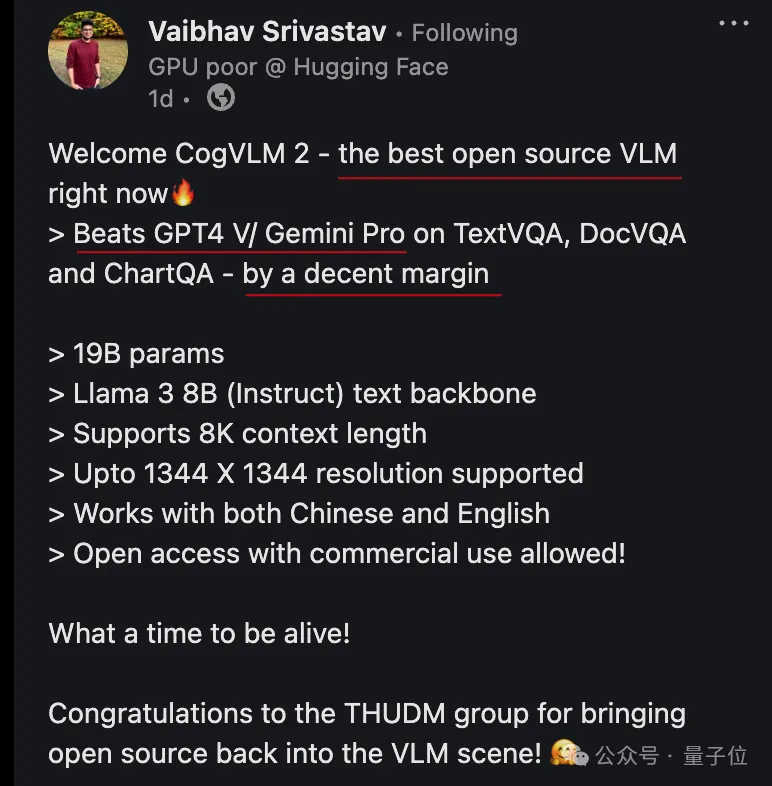
开源多模态SOTA模型再易主!Hugging Face开发者大使刚刚把王冠交给了CogVLM2,来自大模型创业公司智谱AI。CogVLM2甚至在3项基准测试上超过GPT-4v和Gemini Pro,还不是超过一点,是大幅领先。
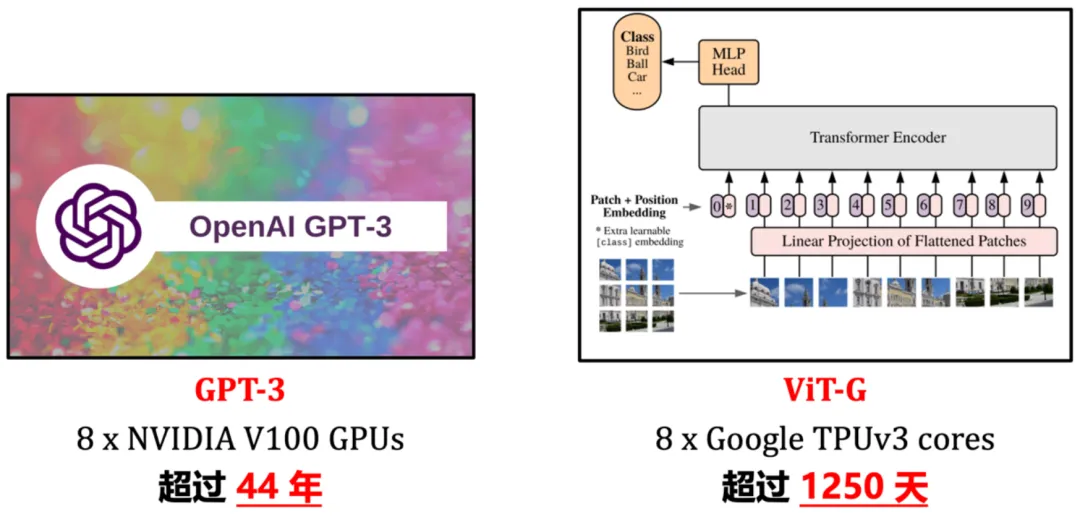
近年来,「scaling」是计算机视觉研究的主角之一。随着模型尺寸和训练数据规模的增大、学习算法的进步以及正则化和数据增强等技术的广泛应用,通过大规模训练得到的视觉基础网络(如 ImageNet1K/22K 上训得的 Vision Transformer、MAE、DINOv2 等)已在视觉识别、目标检测、语义分割等诸多重要视觉任务上取得了令人惊艳的性能。
近日,西交微软北大联合提出信息密集型训练大法,使用纯数据驱动的方式,矫正LLM训练过程产生的偏见,在一定程度上治疗了大语言模型丢失中间信息的问题。
近日,又一惊人结论登上Hacker News热榜:没有指数级数据,就没有Zero-shot!多模态模型被扒实际上没有什么泛化能力,生成式AI的未来面临严峻挑战。
Llama 3发布一个月后,一位开发者在GitHub上创建了名为「从头开始实现Llama 3」的项目,引起了开源社区的广泛关注。代码非常详细地展现了Llama所使用的Transformer架构,甚至让Andrej Karpathy亲自下场「背书」。

5月16日,索尼音乐在官网上发布了一则声明,宣告索尼音乐将退出AI训练,禁止任何企业在尚未取得授权的状态下,以其内容训练AI模型,包括且不限于旋律、歌词、音频录音、视听录音、插图、肖像等。
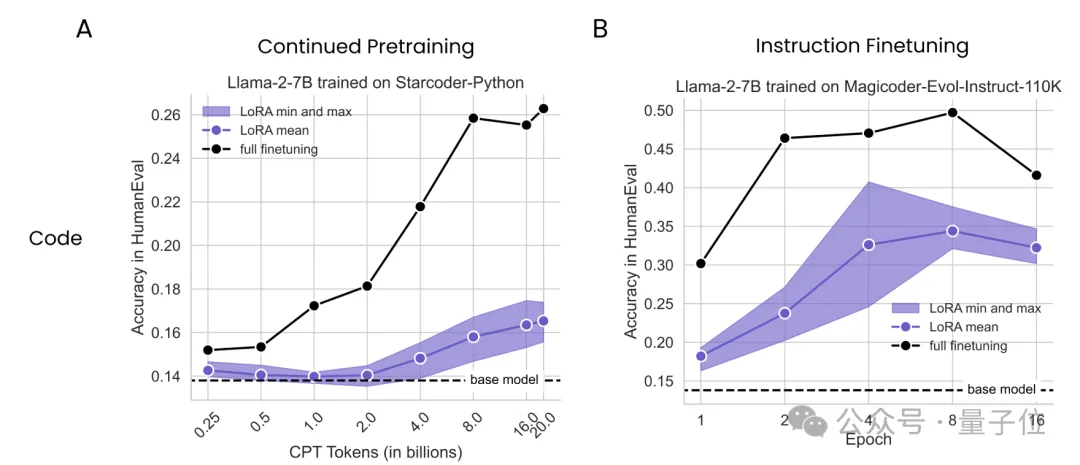
大数据巨头Databricks与哥伦比亚大学最新研究发现,在数学和编程任务上,LoRA干不过全量微调。
当计算预算低时,重复使用高质量数据更好;当不差钱时,使用大量数据更有利。
前几天,普林斯顿大学联合Meta在arXiv上发表了他们最新的研究成果——Lory模型,论文提出构建完全可微的MoE模型,是一种预训练自回归语言模型的新方法。