rollout预算最该花在哪?不是Transformer,而是风险预测的向前一步|NeurIPS'26
rollout预算最该花在哪?不是Transformer,而是风险预测的向前一步|NeurIPS'26国防科技大学与清华大学团队提出ICRPM(In-Context Risk Predictive Model),利用近期任务—风险记录预测策略更新后的风险,在无需额外rollout或环境交互的情况下提升大模型RLVR、Meta-RL及鲁棒控制中的任务排序与训练效果。
搜索
国防科技大学与清华大学团队提出ICRPM(In-Context Risk Predictive Model),利用近期任务—风险记录预测策略更新后的风险,在无需额外rollout或环境交互的情况下提升大模型RLVR、Meta-RL及鲁棒控制中的任务排序与训练效果。
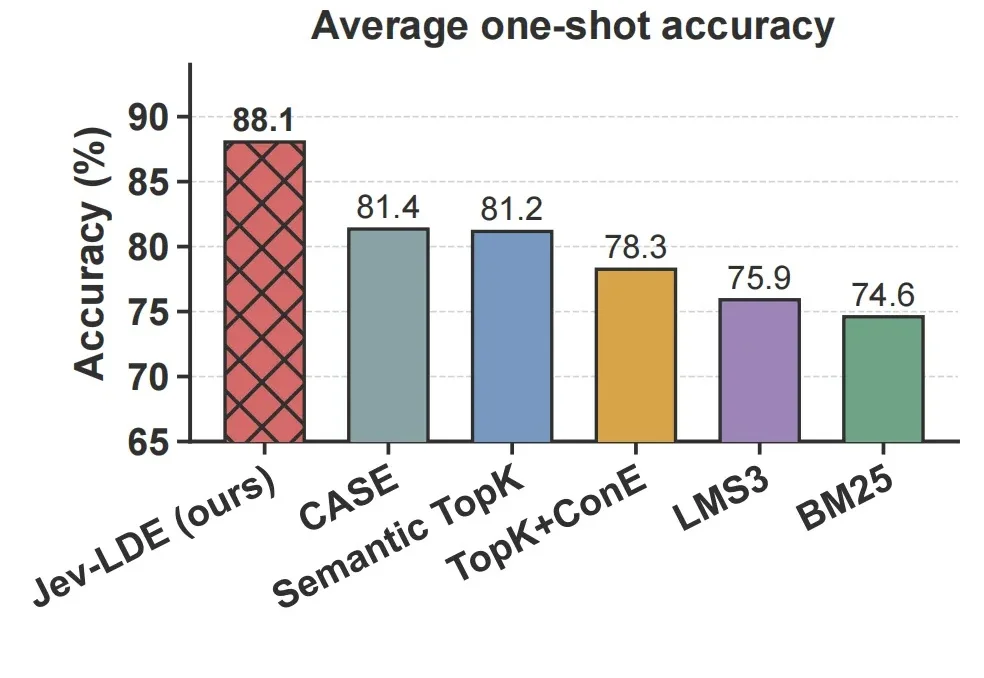
大模型做 In-Context Learning(ICL,上下文学习)时,通常会先从示例库里检索若干 demonstration,再把这些示例和当前问题一起放进 prompt。
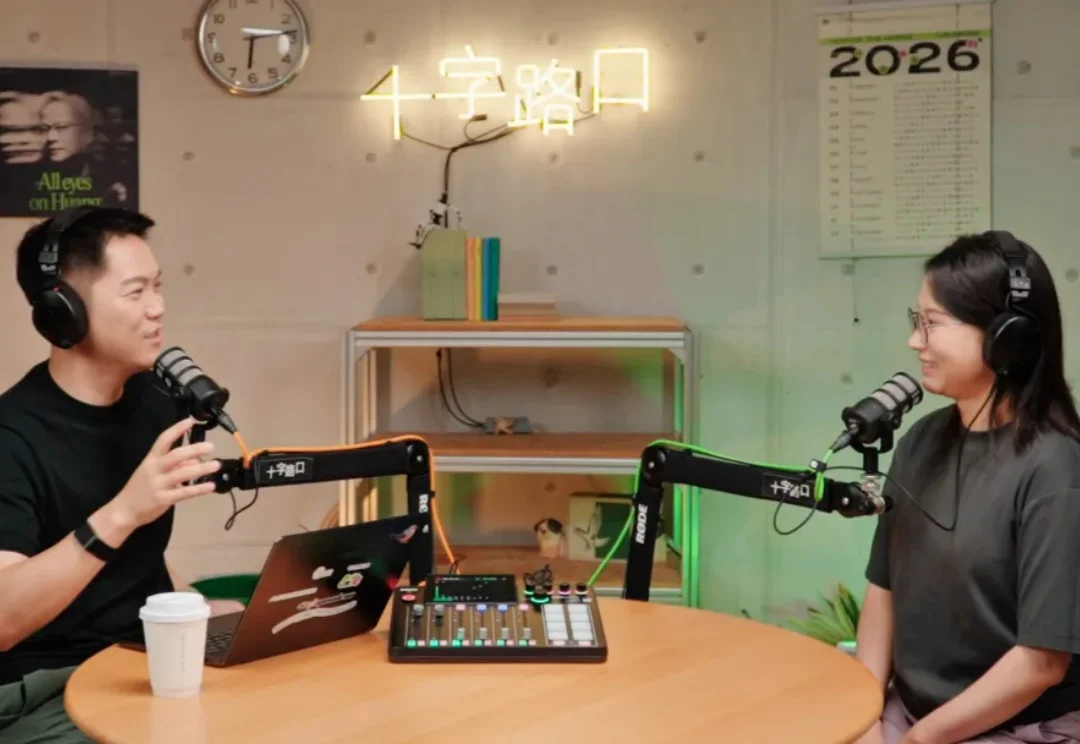
本周「十字路口」的嘉宾是清华叉院助理教授徐梦迪。从清华车辆工程出发,途经 Johns Hopkins、CMU,再到 Stanford 吴佳俊、李飞飞组做博士后,2024 年初她选择回国,加入清华交叉信息研究院。她的核心命题是机器人的 In-Context Learning (ICL):让机器人到一个新环境,通过一两次交互当场学会新任务,而且越学越快。
模型不更新,能力却持续增长。
COCO Matrix CEO高宇翔在访谈中提出,真实世界不可能被提前穷举,具身智能应将In-Context Learning作为核心范式,让机器人通过现场示范和纠正直接适应新任务与新环境,而非每遇到新任务都依赖重新采集大量数据并训练模型,从而显著降低部署门槛和适配成本。
从《四驱兄弟》里那些在赛道上奔跑的机械想象,到后来扎进机器人学习领域的漫长探索,徐梦迪始终被同一个问题牵引:机器要怎样进入物理世界,并在那里持续生长。
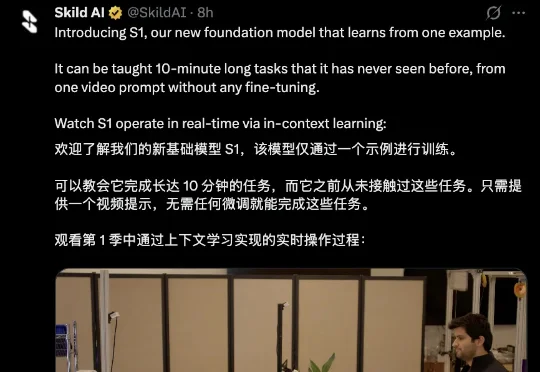
刚刚,北美具身初创Skild AI又发布了全新机器人基础模型S1,直接把机器人上下文学习的任务长度拉到了10分钟往上。这次的S1主打上下文学习(in-context learning,ICL):无需在后训练阶段专门学习新的操作数据,只需看一段人类示范视频,就能“照猫画虎”,直接完成一整套从未见过的复杂操作流程。
近年来,大语言模型展现出了越来越强的能力,从上下文学习(In-Context Learning, ICL)到复杂推理、代码生成,这些能力不断刷新人们对模型能力边界的认知。
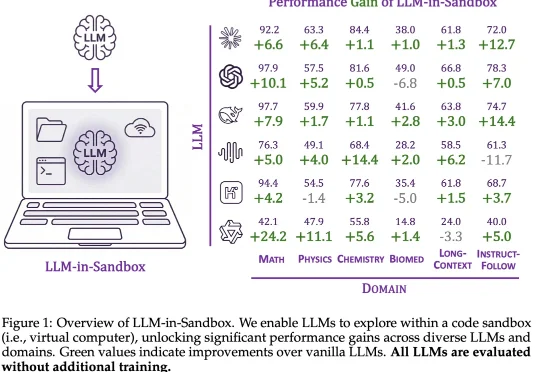
大模型的能力正在被不同的范式逐步解锁:In-Context Learning 展示了模型无需微调即可泛化到新任务;Chain-of-Thought 通过引导模型分步推理来提升复杂问题的求解能力;近期,智能体框架则赋予模型调用工具、多轮交互的能力。
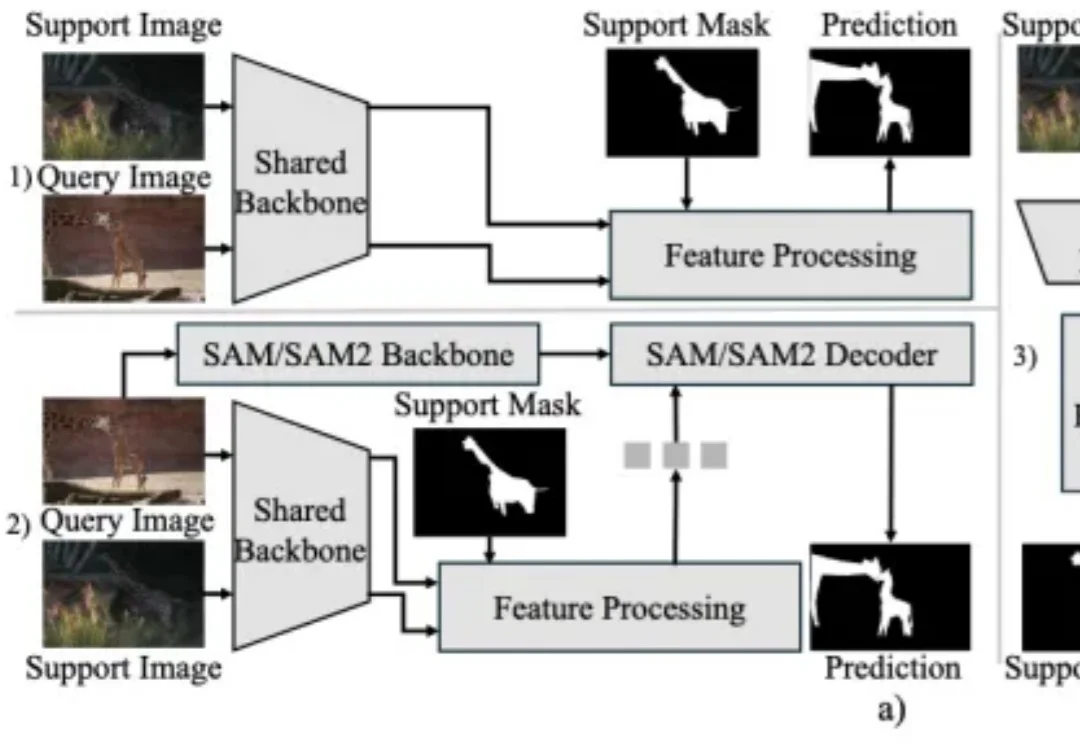
上下文分割(In-Context Segmentation)旨在通过参考示例指导模型实现对特定目标的自动化分割。尽管 SAM 凭借卓越的零样本泛化能力为此提供了强大的基础,但将其应用于此仍受限于提示(如点或框)构建,这样的需求不仅制约了批量推理的自动化效率,更使得模型在处理复杂的连续视频时,难以维持时空一致性。