用LaTRO框架,通过自我奖励机制来激发LLM潜在推理能力,基准上提升12.5% |Salesforce重磅
用LaTRO框架,通过自我奖励机制来激发LLM潜在推理能力,基准上提升12.5% |Salesforce重磅大规模语言模型(LLMs)已经在自然语言处理任务中展现了卓越的能力,但它们在复杂推理任务上依旧面临挑战。推理任务通常需要模型具有跨越多个步骤的推理能力,这超出了LLMs在传统训练阶段的表现。
来自主题: AI资讯
9181 点击 2024-11-15 10:34

 搜索
大规模语言模型(LLMs)已经在自然语言处理任务中展现了卓越的能力,但它们在复杂推理任务上依旧面临挑战。推理任务通常需要模型具有跨越多个步骤的推理能力,这超出了LLMs在传统训练阶段的表现。
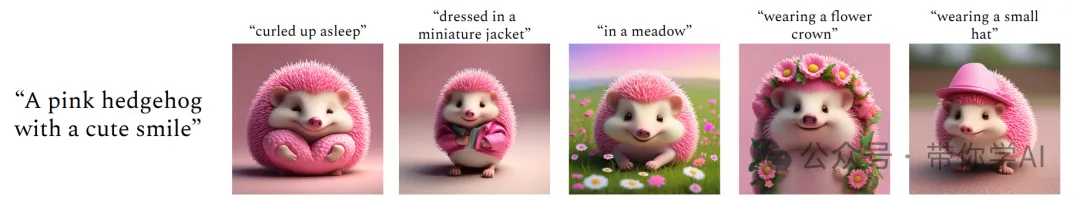
文本到图像的生成模型让创作更加灵活,用户可以用自然语言引导生成图像。
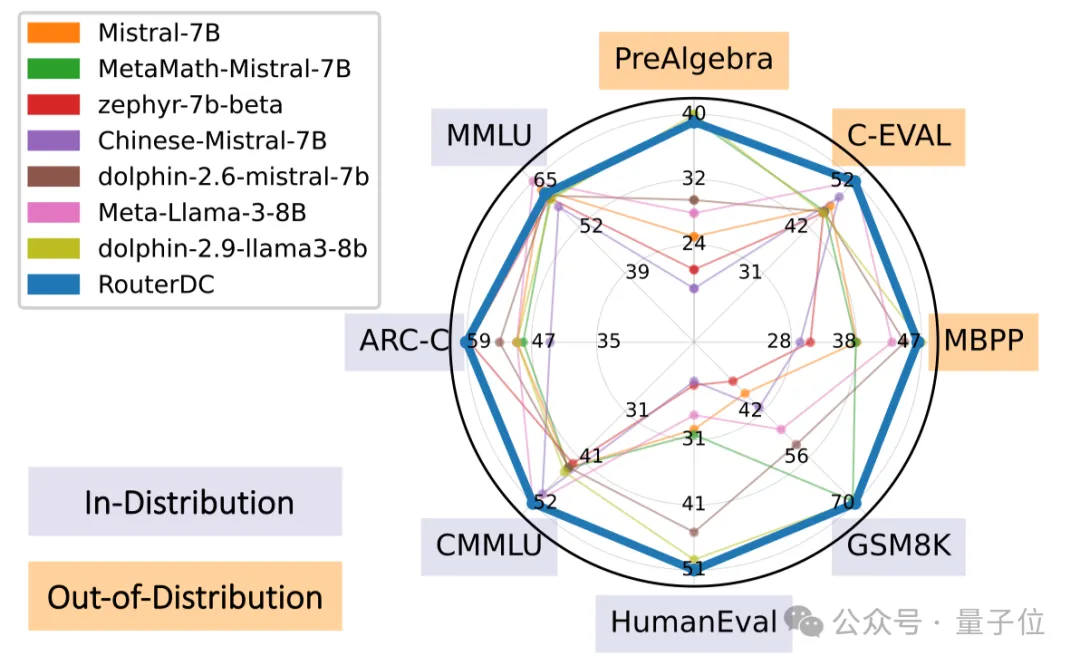
高效组合多个大模型“取长补短”新思路,被顶会NeurIPS 2024接收。
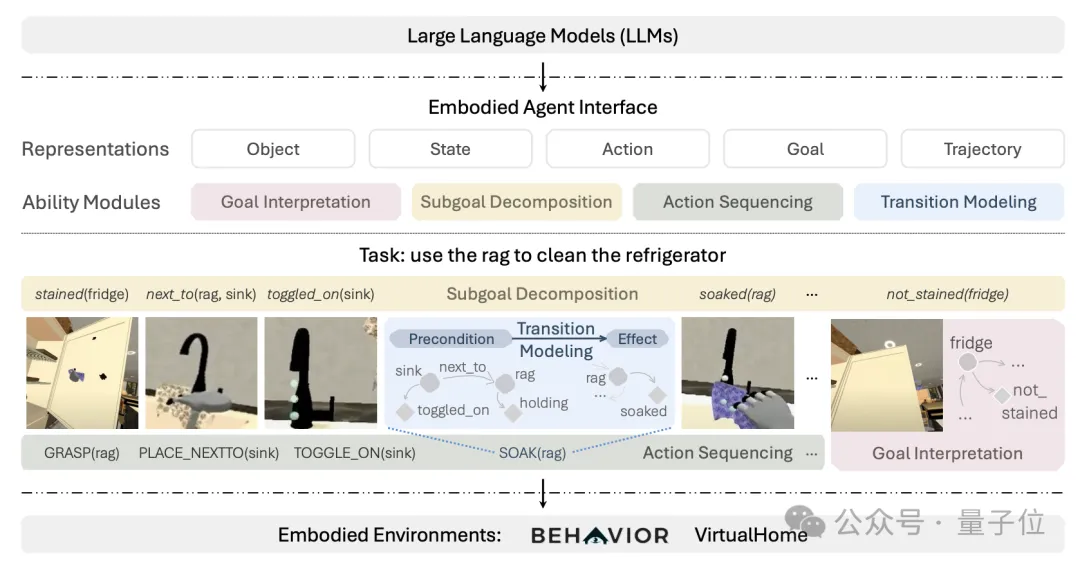
大模型的具身智能决策能力,终于有系统的通用评估基准了。
传统的训练方法通常依赖于大量人工标注的数据和外部奖励模型,这些方法往往受到成本、质量控制和泛化能力的限制。因此,如何减少对人工标注的依赖,并提高模型在复杂推理任务中的表现,成为了当前的主要挑战之一。
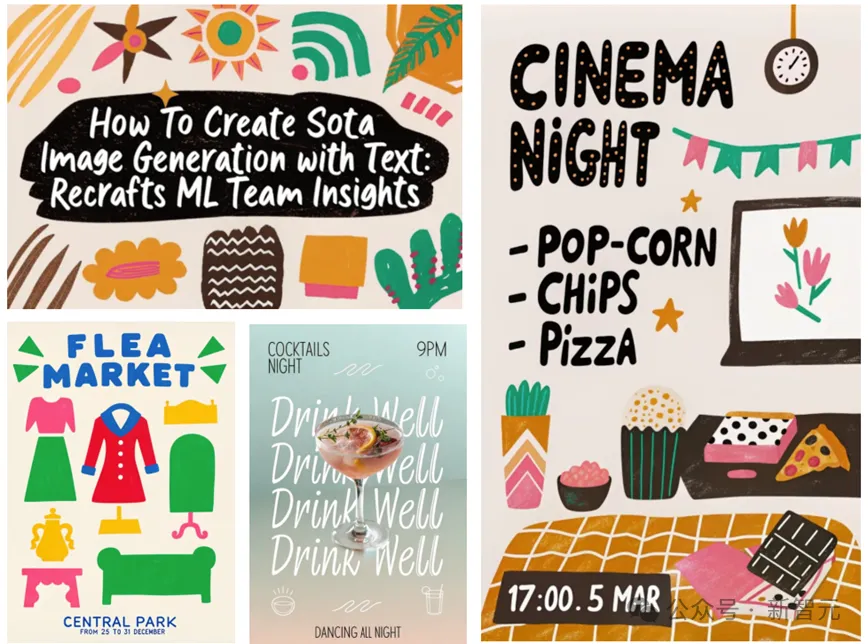
Recraft团队通过结合TextDiffuser-2技术和自训练的大型语言模型,提升了文本到图像渲染的质量和准确性,不过现有模型在处理复杂语言如中文和未明确指定的文本时,仍存在渲染不准确的问题。
随着人形机器人技术的迅猛发展,如何有效获取高质量的操作数据成为核心挑战。鉴于人类操作行为的复杂性和多样性,如何从真实世界中精准捕捉手与物体交互的完整状态,成为推动人形机器人操作技能学习的关键所在。
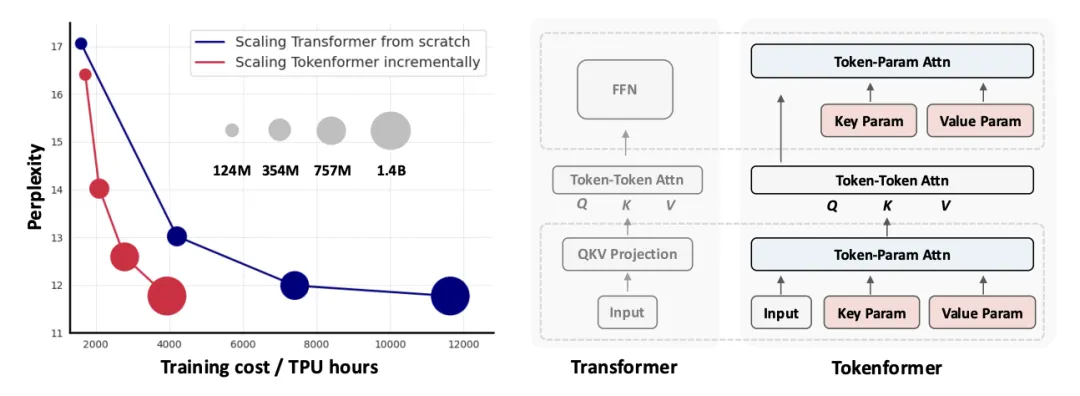
新一代通用灵活的网络结构 TokenFormer: Rethinking Transformer Scaling with Tokenized Model Parameters 来啦!
随着大语言模型(LLMs)在处理复杂任务中的广泛应用,高质量数据的获取变得尤为关键。为了确保模型能够准确理解并执行用户指令,模型必须依赖大量真实且多样化的数据进行后训练。然而,获取此类数据往往伴随着高昂的成本和数据稀缺性。因此,如何有效生成能够反映现实需求的高质量合成数据,成为了当前亟需解决的核心挑战。
LLM未实现机器常识,挑战常识推理。